
Операторы и выражения SQL
В данном руководстве описаны синтаксис и способы использования всех операторов и выражений Tarantool/SQL.
Раздел | Краткое содержание |
|---|---|
ALTER TABLE, CREATE TABLE, DROP TABLE, CREATE VIEW, DROP VIEW, CREATE INDEX, DROP INDEX, CREATE TRIGGER, DROP TRIGGER | |
START TRANSACTION, COMMIT, SAVEPOINT, RELEASE SAVEPOINT, ROLLBACK | |
Например, CAST(...), LENGTH(...), VERSION() |
Синтаксис:
ALTER TABLE {table-name} RENAME TO {new-table-name};ALTER TABLE {table-name} ADD COLUMN {column-name} {column-definition};ALTER TABLE {table-name} ADD CONSTRAINT {constraint-name} {constraint-definition};ALTER TABLE {table-name} DROP CONSTRAINT {constraint-name};ALTER TABLE {table-name} ENABLE|DISABLE CHECK CONSTRAINT {constraint-name};
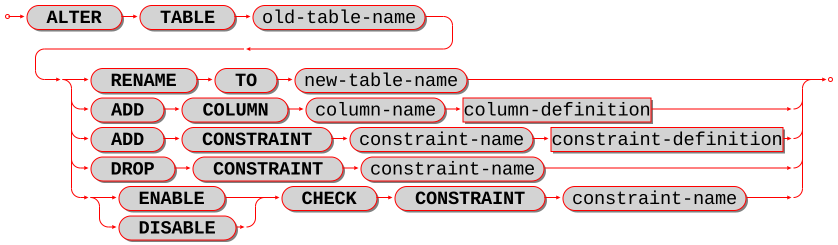
ALTER используется для изменения имени таблицы или её элементов.
Примеры:
Для переименования таблицы с помощью ALTER ... RENAME таблица
old-table должна существовать, а new-table — не должна. Пример:
-- renaming a table: ALTER TABLE t1 RENAME TO t2;
Для добавления колонки с помощью ADD COLUMN таблица
должна существовать и быть пустой, а имя колонки должно быть уникальным
в пределах таблицы. Пример с колонкой типа STRING, значение которой
должно начинаться с X:
ALTER TABLE t1 ADD COLUMN s4 STRING CHECK (s4 LIKE 'X%');
Поддержка ALTER TABLE ... ADD COLUMN добавлена в версии
2.7.1.
Для добавления табличного ограничения с
помощью ADD CONSTRAINT таблица должна существовать и быть пустой, а
имя ограничения должно быть уникальным в пределах таблицы. Пример с
определением ограничения внешнего ключа:
ALTER TABLE t1 ADD CONSTRAINT fk_s1_t1_1 FOREIGN KEY (s1) REFERENCES t1;
Невозможно выполнить CREATE TABLE table_a ... REFERENCES table_b ...,
если таблица b еще не существует. В таких случаях удобно использовать
ALTER TABLE — можно сначала выполнить CREATE TABLE table_a без
внешнего ключа, затем CREATE TABLE table_b, а затем
ALTER TABLE table_a ... REFERENCES table_b ....
-- adding a primary-key constraint definition:-- This is unusual because primary keys are created automatically-- and it is illegal to have two primary keys for the same table.-- However, it is possible to drop a primary-key index, and this-- is a way to restore the primary key if that happens.ALTER TABLE t1 ADD CONSTRAINT "pk_unnamed_T1_1" PRIMARY KEY (s1);-- adding a unique-constraint definition:-- Alternatively, you can say CREATE UNIQUE INDEX unique_key ON t1 (s1);ALTER TABLE t1 ADD CONSTRAINT "unique_unnamed_T1_2" UNIQUE (s1);-- Adding a check-constraint definition:ALTER TABLE t1 ADD CONSTRAINT "ck_unnamed_T1_1" CHECK (s1 > 0);
Для ALTER ... DROP CONSTRAINT удалять можно только именованные
ограничения. (Tarantool генерирует имена ограничений автоматически, если
они не заданы пользователем.) Начиная с версии
2.4.1 можно удалять
любые именованные табличные ограничения, а именно: PRIMARY KEY, UNIQUE,
FOREIGN KEY и CHECK.
Чтобы удалить ограничение уникальности, используйте
ALTER ... DROP CONSTRAINT или DROP INDEX — при
этом ограничение также будет удалено.
-- dropping a constraint:ALTER TABLE t1 DROP CONSTRAINT "fk_unnamed_JJ2_1";
Для ALTER ... ENABLE|DISABLE CHECK CONSTRAINT можно включать или
отключать только именованные ограничения, причём Tarantool ищет
совпадения только среди имён ограничений типа CHECK. По умолчанию
ограничение включено. Если ограничение отключено, проверка не
выполняется.
-- disabling and re-enabling a constraint:ALTER TABLE t1 DISABLE CHECK CONSTRAINT c;ALTER TABLE t1 ENABLE CHECK CONSTRAINT c;
Ограничения:
- Нельзя удалить колонку.
- Нельзя изменить ограничения NOT NULL или свойства колонки DEFAULT
и тип данных. Однако их можно изменить
средствами Tarantool/NOSQL, например, вызвав
space_object:format() с другим значением
параметра
is_nullable.
Синтаксис:
CREATE TABLE [IF NOT EXISTS] {table-name} (column-definition or table-constraint list) [WITH ENGINE = {string}];
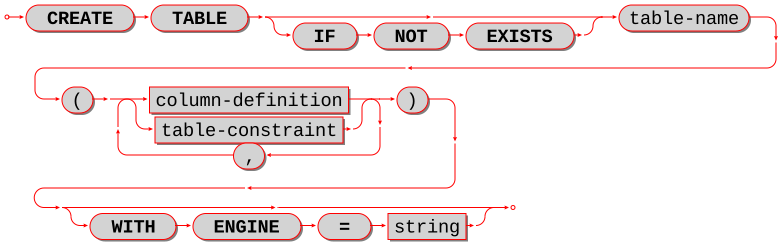
Создание новой базовой таблицы, обычно называемой просто «таблицей».
Имя таблицы (table-name) должно быть идентификатором, допустимым согласно правилам для идентификаторов, и не должно совпадать с именем уже существующей базовой таблицы или представления.
Список определений колонок (column-definition) или ограничений таблицы (table-constraint) — это разделенный запятыми список определений колонок или определений ограничений таблицы. Определения колонок и определения ограничений таблицы иногда называются элементами таблицы (table elements).
Правила:
- Первичный ключ обязателен; он может быть задан с помощью ограничения таблицы PRIMARY KEY.
- Должен быть хотя бы одна колонка.
- Если указано IF NOT EXISTS и таблица с таким именем уже существует, оператор игнорируется.
- Если указано
WITH ENGINE = {string}, где{string}должно быть 'memtx' или 'vinyl', таблица создается с использованием соответствующего движка хранения. Если это предложение не указано, таблица создается с движком по умолчанию, которым обычно является 'memtx', но может быть изменен путем обновления системной таблицы box.space._session_settings.
Действия:
- Tarantool обрабатывает каждое определение колонки и ограничение таблицы и возвращает ошибку при нарушении любого из правил.
- Tarantool создает новое определение в схеме.
- Tarantool создает новые индексы для PRIMARY KEY или ограничений UNIQUE. Имя уникального индекса создается автоматически.
- Обычно Tarantool фактически выполняет оператор COMMIT.
Примеры:
-- the simplest form, with one column and one constraint:CREATE TABLE t1 (s1 INTEGER, PRIMARY KEY (s1));-- you can see the effect of the statement by querying-- Tarantool system spaces:SELECT * FROM "_space" WHERE "name" = 'T1';SELECT * FROM "_index" JOIN "_space" ON "_index"."id" = "_space"."id"WHERE "_space"."name" = 'T1';-- variation of the simplest form, with delimited identifiers-- and a bracketed comment:CREATE TABLE "T1" ("S1" INT /* synonym of INTEGER */, PRIMARY KEY ("S1"));-- two columns, one named constraintCREATE TABLE t1 (s1 INTEGER, s2 STRING, CONSTRAINT pk_s1s2_t1_1 PRIMARY KEY (s1, s2));
Ограничения:
- Максимальное количество колонок — 2000.
- Максимальная длина строки зависит от параметра конфигурации memtx_max_tuple_size или vinyl_max_tuple_size.
Синтаксис:
column-name data-type [, column-constraint]
Определение колонки — это элемент таблицы, используемый в операторе CREATE TABLE.
Имя колонки (column-name) должно быть идентификатором, допустимым
согласно правилам для идентификаторов.
Каждое имя колонки (column-name) должно быть уникальным в пределах
таблицы.
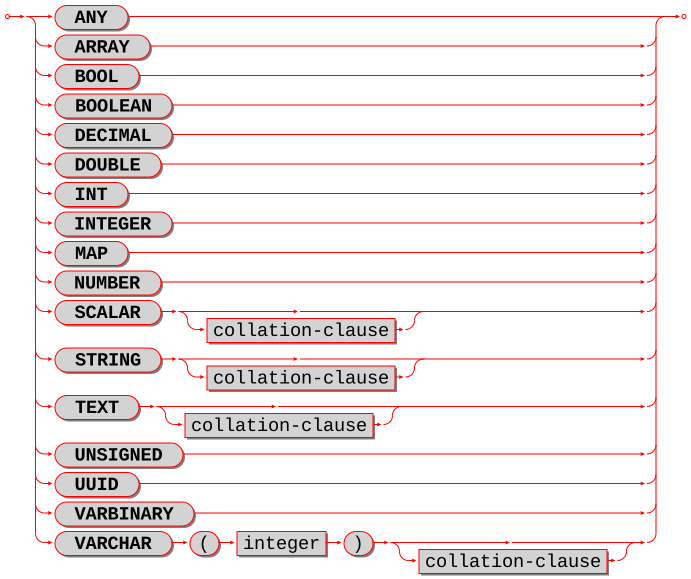
Каждая колонка имеет тип данных: ANY, ARRAY, BOOLEAN, DECIMAL, DOUBLE, INTEGER, MAP, NUMBER, SCALAR, STRING, UNSIGNED, UUID или VARBINARY. Подробное описание типов данных приведено в разделе Операнды.
Правила для типа данных SCALAR были существенно изменены в версии
Tarantool 2.10.0.
SCALAR — это «сложный» тип данных, в отличие от всех остальных типов данных, которые являются «примитивными». Два значения в колонке типа SCALAR могут иметь два разных примитивных типа данных.
-
Любой элемент, определенный как SCALAR, имеет базовый примитивный тип. Например, здесь:
CREATE TABLE t (s1 SCALAR PRIMARY KEY);INSERT INTO t VALUES (55), ('41');базовый примитивный тип элемента в первой строке — INTEGER, потому что литерал 55 имеет тип данных INTEGER, а базовый примитивный тип во второй строке — STRING (тип данных литерала всегда понятен по его формату).
Примитивный тип элемента гораздо менее важен, чем его установленный тип. Tarantool может определить примитивный тип по тому, как MsgPack хранит его, но это уже детали реализации.
-
В определении SCALAR нельзя задать максимальную длину, так как ограничение длины не предусмотрено.
-
В определении SCALAR может присутствовать предложение COLLATE, которое влияет на все элементы, чей примитивный тип данных — STRING. Сортировка по умолчанию — «binary».
-
Некоторые присваивания недопустимы при несовпадении типов данных, но допустимы, если целевой элемент имеет тип SCALAR. Например,
UPDATE ... SET column1 = 'a'недопустимо, еслиcolumn1определен как INTEGER, но допустимо, еслиcolumn1определен как SCALAR — значения, которые оказались типа INTEGER, будут изменены так, чтобы их тип данных стал SCALAR. -
Не существует синтаксиса литералов, подразумевающего тип данных SCALAR.
-
TYPEOF(x) всегда возвращает 'scalar' или 'NULL', но никогда не возвращает базовый тип данных. Более того, не существует функции, гарантированно возвращающей базовый тип данных. Например,
TYPEOF(CAST(1 AS SCALAR));возвращает 'scalar', а не 'integer'. -
Для любой операции, требующей неявного приведения типа от элемента, определенного как SCALAR, операция завершится ошибкой во время выполнения. Например, если определение такое:
CREATE TABLE t (s1 SCALAR PRIMARY KEY, s2 INTEGER);а единственная строка в таблице T имеет s1 = 1, то есть её базовый примитивный тип — INTEGER, тогда
UPDATE t SET s2 = s1;недопустимо. -
Для любой бинарной операции, требующей неявного приведения типов для сравнения, синтаксис допустим, и операция не завершится ошибкой во время выполнения. Рассмотрим такую ситуацию: сравнение примитивного типа VARBINARY с примитивным типом STRING.
CREATE TABLE t (s1 SCALAR PRIMARY KEY);INSERT INTO t VALUES (X'41');SELECT * FROM t WHERE s1 > 'a';Это сравнение допустимо, так как Tarantool знает порядок X'41' и 'a' в Tarantool/NoSQL 'scalar' — это случай, когда примитивный тип имеет значение.
-
Тип данных результата операции min/max над колонкой, определенным как SCALAR, — SCALAR. Пользователям необходимо заранее знать базовый примитивный тип результата. Например:
CREATE TABLE t (s1 INTEGER, s2 SCALAR PRIMARY KEY);INSERT INTO t VALUES (1, X'44'), (2, 11), (3, 1E4), (4, 'a');SELECT cast(min(s2) AS INTEGER), hex(cast(max(s2) as VARBINARY)) FROM t;Результатом будет:
- - [11, '44',]Такой результат возможен только благодаря правилам работы со scalar в Tarantool/NoSQL, а вот
SELECT SUM(s2)было бы недопустимо, поскольку сложение в этом случае потребовало бы неявного приведения из VARBINARY к числовому типу, что лишено смысла. -
Тип данных результата примитивной комбинации иногда оказывается SCALAR, хотя Tarantool по сути использует примитивный тип данных, а не объявленный. (Здесь слово «комбинация» используется в том же смысле, в каком стандарт использует его в разделе «Result of data type combinations».) Поэтому для
greatest(1E308, 'a', 0, X'00')результатом будет X'00', ноtypeof(greatest(1E308, 'a', 0, X'00')вернет 'scalar'. -
Результат объединения двух значений SCALAR иногда имеет примитивный тип. Например,
SELECT TYPEOF((SELECT CAST('a' AS SCALAR) UNION SELECT CAST('a' AS SCALAR)));возвращает 'string'.
Все типы данных SQL, кроме SCALAR, соответствуют
типам в Tarantool/NoSQL с тем же именем.
Например, тип SQL STRING хранится в пространстве NoSQL как тип
'string'.
Следовательно, указание типа данных SQL X определяет, что данные будут храниться в пространстве со колонкой формата, указывающим, что тип NoSQL — 'x'.
Правила для этого типа NoSQL применимы к типу данных SQL.
Если два элемента имеют типы данных SQL с одинаковым базовым типом, то они совместимы для любых целей присваивания или сравнения.
Если два элемента имеют типы данных SQL с разными базовыми типами, то применяются правила явного приведения типов, неявного приведения (при присваивании) или неявного приведения (при сравнении).
Существует одно значение с плавающей точкой, которое не обрабатывается
SQL: -NaN воспринимается как NULL, хотя его тип данных —
'double'.
До Tarantool 2.10.0
существовали также некоторые типы данных Tarantool/NoSQL, не имевшие
соответствующих типов данных SQL. Например, запрос
SELECT "flags" FROM "_vspace"; возвращал колонку, типом данных SQL
которого является VARBINARY, а не MAP. С такими колонками в SQL можно
работать только посредством вызова Lua-функций.
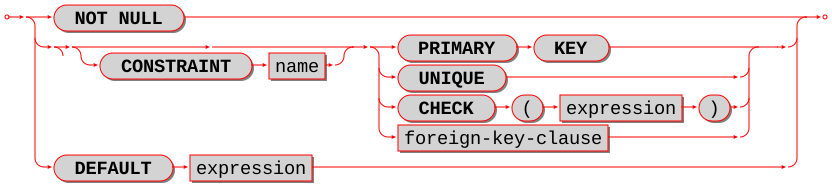
Ограничение колонки или предложение по умолчанию может быть следующим:
Тип | Комментарий |
|---|---|
NOT NULL | означает «присвоение NULL этой колонке недопустимо» |
PRIMARY KEY | описано в разделе Определение ограничения таблицы |
UNIQUE | описано в разделе Определение ограничения таблицы |
CHECK (expression) | описано в разделе Определение ограничения таблицы |
foreign-key-clause | описано в разделе Определение ограничения таблицы для внешних ключей |
DEFAULT expression | означает «если INSERT не присваивает значение этой колонке, то ему присваивается результат вычисления expression» — если предложение DEFAULT отсутствует, подразумевается DEFAULT NULL |
Если ограничение колонки — PRIMARY KEY, это сокращенная запись отдельного определения ограничения таблицы: "PRIMARY KEY (column-name)".
Если ограничение колонки — UNIQUE, это сокращенная запись отдельного определения ограничения таблицы: "UNIQUE (column-name)".
Если ограничение колонки — CHECK, это сокращенная запись отдельного определения ограничения таблицы: "CHECK (expression)".
Для колонок, определенных с PRIMARY KEY, ограничение NOT NULL применяется автоматически.
Чтобы задать ограничения, которые Tarantool не применяет автоматически, добавьте предложения CHECK, например:
CREATE TABLE t ("smallint" INTEGER PRIMARY KEY CHECK ("smallint" <= 32767 AND "smallint" >= -32768));CREATE TABLE t ("shorttext" STRING PRIMARY KEY CHECK (length("shorttext") <= 10));
однако это может замедлить операции вставки и обновления.
Ниже приведены примеры в инструкциях CREATE TABLE. Типы данных также могут использоваться в функциях CAST.
-- the simple form with column-name and data-typeCREATE TABLE t (column1 INTEGER ...);-- with column-name and data-type and column-constraintCREATE TABLE t (column1 STRING PRIMARY KEY ...);-- with column-name and data-type and collate-clauseCREATE TABLE t (column1 SCALAR COLLATE "unicode" ...);
-- with all possible data types and aliasesCREATE TABLE t(column1 BOOLEAN, column2 BOOL,column3 INT PRIMARY KEY, column4 INTEGER,column5 DOUBLE,column6 NUMBER,column7 STRING, column8 STRING COLLATE "unicode",column9 TEXT, columna TEXT COLLATE "unicode_sv_s1",columnb VARCHAR(0), columnc VARCHAR(100000) COLLATE "binary",columnd UUID,columne VARBINARY,columnf SCALAR, columng SCALAR COLLATE "unicode_uk_s2",columnh DECIMAL,columni ARRAY,columnj MAP,columnk ANY);
-- with all possible column constraints and a default clauseCREATE TABLE t(column1 INTEGER NOT NULL,column2 INTEGER PRIMARY KEY,column3 INTEGER UNIQUE,column4 INTEGER CHECK (column3 > column2),column5 INTEGER REFERENCES t,column6 INTEGER DEFAULT NULL);
Ограничение constraint таблицы ограничивает данные, которые можно добавить в таблицу. При попытке вставить недопустимые данные в колонку Tarantool выбрасывает ошибку.
Ограничение таблицы имеет следующий синтаксис:
[CONSTRAINT [name]] constraint_expressionconstraint_expression:| PRIMARY KEY (column_name, ...)| UNIQUE (column_name, ...)| CHECK (expression)| FOREIGN KEY (column_name, ...) foreign_key_clause
Определяет ограничение — элемент таблицы, используемый в инструкции CREATE TABLE.
Имя ограничения должно быть идентификатором, допустимым согласно правилам для идентификаторов. Имя ограничения должно быть уникальным в пределах таблицы для конкретного типа ограничения. Например, ограничения CHECK и FOREIGN KEY могут иметь одинаковые имена.
Ограничения PRIMARY KEY
Ограничения PRIMARY KEY выглядят так:
PRIMARY KEY (column_name, ...)
Существует краткая форма: указание PRIMARY KEY в определении колонки.
-
Каждая таблица должна иметь один и только один первичный ключ.
-
Колонки первичного ключа автоматически получают
NOT NULL. -
Для колонок первичного ключа автоматически создается индекс.
-
Значения в колонках первичного ключа уникальны. Это означает, что наличие двух строк с одинаковыми значениями для колонок, указанных в ограничении, недопустимо. Пример 1: первичный ключ из одной колонки
- Создайте таблицу
authorс первичным ключом в колонкеid:
CREATE TABLE author (id INTEGER PRIMARY KEY,name STRING NOT NULL);
Вставьте данные в эту таблицу:
INSERT INTO author VALUES (1, 'Leo Tolstoy'),(2, 'Fyodor Dostoevsky');
2. При попытке добавить автора с уже существующим идентификатором возникает следующая ошибка:
INSERT INTO author VALUES (2, 'Alexander Pushkin');/*- Duplicate key exists in unique index "pk_unnamed_author_1" in space "author" withold tuple - [2, "Fyodor Dostoevsky"] and new tuple - [2, "Alexander Pushkin"]*/
Пример 2: первичный ключ из двух колонок
- Создайте таблицу
bookс первичным ключом, определенным для двух колонок:
CREATE TABLE book (id INTEGER,title STRING NOT NULL,PRIMARY KEY (id, title));
Вставьте данные в эту таблицу:
INSERT INTO book VALUES (1, 'War and Peace'),(2, 'Crime and Punishment');
2. При попытке добавить уже существующую книгу возникает следующая ошибка:
INSERT INTO book VALUES (2, 'Crime and Punishment');/*- Duplicate key exists in unique index "pk_unnamed_book_1" in space "BOOK" with oldtuple - [2, "Crime and Punishment"] and new tuple - [2, "Crime and Punishment"]*/
PRIMARY KEY с модификатором AUTOINCREMENT может быть указан одним из двух способов:
-
В определении колонки после слов PRIMARY KEY, например:
CREATE TABLE t (c INTEGER PRIMARY KEY AUTOINCREMENT); -
В выражении PRIMARY KEY (column-list) после имени колонки, например:
CREATE TABLE t (c INTEGER, PRIMARY KEY (c AUTOINCREMENT));Если указан AUTOINCREMENT, колонка должна быть колонкой первичного ключа и иметь тип INTEGER или UNSIGNED.
Только одна колонка в таблице может быть автоинкрементной. Однако
допустимо указать PRIMARY KEY (a, b, c AUTOINCREMENT) — в этом
случае первичный ключ состоит из трех колонок, но только третья колонка
(c) является AUTOINCREMENT.
Как следует из названия, значения в автоинкрементной колонке увеличиваются автоматически. Это означает: если пользователь вставляет NULL в такую колонку, сохраненное значение будет наименьшим неотрицательным целым числом, которое еще не использовалось. Это происходит потому, что автоинкрементные колонки связаны с последовательностями.
Ограничения UNIQUE
Ограничения UNIQUE выглядят так:
UNIQUE (column_name, ...)
Существует краткая форма: указание UNIQUE в определении колонки.
Ограничения UNIQUE аналогичны ограничениям PRIMARY KEY, за исключением того, что:
-
Таблица может иметь любое количество уникальных ключей, и уникальные ключи автоматически не получают NOT NULL.
-
Для уникальных колонок автоматически создается индекс.
-
Значения в уникальных колонках уникальны. Это означает, что наличие двух строк с одинаковыми значениями в колонках уникального ключа недопустимо. Пример 1: ограничение UNIQUE для одной колонки
- Создайте таблицу
authorс уникальной колонкойname:
CREATE TABLE author (id INTEGER PRIMARY KEY,name STRING UNIQUE);
Вставьте данные в эту таблицу:
INSERT INTO author VALUES (1, 'Leo Tolstoy'),(2, 'Fyodor Dostoevsky');
2. При попытке добавить автора с таким же именем возникает следующая ошибка:
INSERT INTO author VALUES (3, 'Leo Tolstoy');/*- Duplicate key exists in unique index "unique_unnamed_author_2" in space "author"with old tuple - [1, "Leo Tolstoy"] and new tuple - [3, "Leo Tolstoy"]*/
Пример 2: ограничение UNIQUE для двух колонок
- Создайте таблицу
bookс ограничением UNIQUE, определенным для двух колонок:
CREATE TABLE book (id INTEGER PRIMARY KEY,title STRING NOT NULL,author_id INTEGER UNIQUE,UNIQUE (title, author_id));
Вставьте данные в эту таблицу:
INSERT INTO book VALUES (1, 'War and Peace', 1),(2, 'Crime and Punishment', 2);
2. При попытке добавить книгу с дублирующимися значениями возникает следующая ошибка:
INSERT INTO book VALUES (3, 'War and Peace', 1);/*- Duplicate key exists in unique index "unique_unnamed_book_2" in space "book" withold tuple - [1, "War and Peace", 1] and new tuple - [3, "War and Peace", 1]*/
Ограничения CHECK
Ограничение CHECK используется для ограничения диапазона значений, которые могут храниться в колонке. Ограничения CHECK выглядят так:
CHECK (expression)
Существует краткая форма: указание CHECK в определении колонки.
Выражение может быть любым, что возвращает логический результат: TRUE,
FALSE или UNKNOWN.
Выражение не может содержать
подзапрос.
Если выражение содержит имя колонки, этот
колонка должна существовать в таблице.
Если указано ограничение
CHECK, таблица не должна содержать строки, для которых выражение
возвращает FALSE. (Таблица может содержать строки, для которых выражение
возвращает TRUE или UNKNOWN.)
Проверку ограничения можно
приостановить с помощью
ALTER TABLE ... DISABLE CHECK CONSTRAINT и
возобновить с помощью ALTER TABLE ... ENABLE CHECK CONSTRAINT.
Пример
- Создайте таблицу
authorсо колонкойname, значения в котором должны содержать более 4 символов:
CREATE TABLE author (id INTEGER PRIMARY KEY,name STRING,CONSTRAINT check_name_length CHECK (CHAR_LENGTH(name) > 4));
Вставьте данные в эту таблицу:
INSERT INTO author VALUES (1, 'Leo Tolstoy'),(2, 'Fyodor Dostoevsky');
2. При попытке добавить автора с именем короче 5 символов возникает следующая ошибка:
INSERT INTO author VALUES (3, 'Alex');/*- Check constraint 'check_name_length' failed for a tuple*/
Внешний ключ — это ограничение, которое можно использовать для обеспечения целостности данных между связанными таблицами. Ограничение внешнего ключа определяется в дочерней таблице и ссылается на значения колонок родительской таблицы.
Ограничения внешнего ключа выглядят так:
FOREIGN KEY (referencing_column_name, ...)REFERENCES referenced_table_name (referenced_column_name, ...)
Ссылку также можно добавить в определении колонки:
referencing_column_name column_definitionREFERENCES referenced_table_name(referenced_column_name)
Обратите внимание, что ссылочная колонка должна соответствовать одному из следующих требований:
-
Ссылочная колонка является колонкой PRIMARY KEY.
-
Ссылочная колонка имеет ограничение UNIQUE.
-
Для ссылочной колонки создан индекс UNIQUE. Обратите внимание, что до версии 2.11.0 наличие индекса для ссылочных колонок проверялось при создании ограничения (например, с помощью
CREATE TABLEилиALTER TABLE). Начиная с версии 2.11.0 эта проверка ослаблена: наличие индекса проверяется при вставке данных.
Пример
В этом примере показано, как создать связь между родительской и дочерней таблицами через внешний ключ из одной колонки:
- Сначала создайте родительскую таблицу
author:
CREATE TABLE author (id INTEGER PRIMARY KEY,name STRING NOT NULL);
Вставьте данные в эту таблицу:
INSERT INTO author VALUES (1, 'Leo Tolstoy'),(2, 'Fyodor Dostoevsky');
- Создайте дочернюю таблицу
book, колонкаauthor_idкоторой ссылается на колонкуidиз таблицыauthor:
CREATE TABLE book (id INTEGER PRIMARY KEY,title STRING NOT NULL,author_id INTEGER NOT NULL UNIQUE,FOREIGN KEY (author_id)REFERENCES author (id));
Альтернативный вариант — добавить ссылку в определении колонки:``` sqlCREATE TABLE book (id INTEGER PRIMARY KEY,title STRING NOT NULL,author_id INTEGER NOT NULL UNIQUE REFERENCES author(id));```Вставьте данные в таблицу `book`:
INSERT INTO book VALUES (1, 'War and Peace', 1),(2, 'Crime and Punishment', 2);
3. Проверьте, как созданное ограничение внешнего ключа обеспечивает целостность данных.
При попытке вставить новую книгу со значением author_id, которого
нет в родительской таблице author, возникает следующая ошибка:
INSERT INTO book VALUES (3, 'Eugene Onegin', 3);/*- 'Foreign key constraint ''fk_unnamed_book_1'' failed: foreign tuple was not found'*/
При попытке удалить автора, у которого уже есть книги в таблице`book`, возникает следующая ошибка:
DELETE FROM author WHERE id = 2;/*- 'Foreign key ''fk_unnamed_book_1'' integrity check failed: tuple is referenced'*/
Синтаксис:
DROP TABLE [IF EXISTS] {table-name};

Удаление таблицы.
table-name должно указывать на таблицу, созданную ранее с помощью оператора CREATE TABLE.
Правила:
- Если существует представление, ссылающееся на таблицу, удаление завершится ошибкой. Сначала удалите ссылающееся представление с помощью DROP VIEW.
- Если существует внешний ключ, ссылающийся на таблицу, удаление завершится ошибкой. Сначала удалите ссылающееся ограничение с помощью ALTER TABLE ... DROP.
Действия:
- Tarantool возвращает ошибку, если таблица не существует и
отсутствует предложение
IF EXISTS. - Таблица и все ее данные удаляются.
- Все индексы таблицы удаляются.
- Все триггеры таблицы удаляются.
- Обычно Tarantool фактически выполняет оператор COMMIT.
Примеры:
-- the simple case:DROP TABLE t31;-- with an IF EXISTS clause:DROP TABLE IF EXISTS t31;
См. также: DROP VIEW.
Синтаксис:
CREATE VIEW [IF NOT EXISTS] {view-name} [(column-list)] AS subquery;
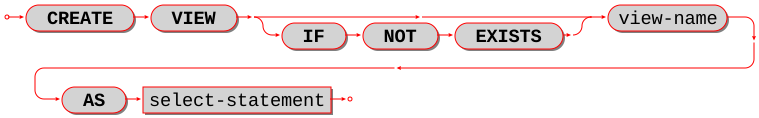
Создание новой виртуальной таблицы, обычно называемой «представлением».
Имя view-name должно соответствовать правилам для идентификаторов.
Необязательный параметр column-list должен представлять собой разделенный запятыми список имен колонок представления.
Синтаксис подзапроса должен совпадать с синтаксисом оператора SELECT или конструкции VALUES.
Правила:
- Не должно существовать базовой таблицы или представления с тем же именем, что и view-name.
- Если указан column-list, количество колонок в column-list должно совпадать с количеством колонок в списке выборки подзапроса.
Действия:
- При нарушении правила Tarantool выдаст ошибку.
- Tarantool создаст новый постоянный объект, имена колонок (column-names) которого будут равны именам из column-list или именам из select list подзапроса.
- Обычно Tarantool фактически выполняет оператор COMMIT.
Примеры:
-- the simple case:CREATE VIEW v AS SELECT column1, column2 FROM t;-- with a column-list:CREATE VIEW v (a,b) AS SELECT column1, column2 FROM t;
Ограничения:
- В представление нельзя вставлять данные, а также обновлять или удалять их, хотя в некоторых случаях альтернативой может стать создание триггера INSTEAD OF.
Синтаксис:
DROP VIEW [IF EXISTS] {view-name};

Удаляет представление.
Имя view-name должно указывать на представление, созданное ранее с помощью оператора CREATE VIEW.
Правила: нет
Действия:
- Tarantool возвращает ошибку, если представление не существует и
отсутствует предложение
IF EXISTS. - Представление удаляется.
- Все триггеры для представления удаляются.
- Обычно Tarantool фактически выполняет оператор COMMIT.
Примеры:
-- the simple case:DROP VIEW v31;-- with an IF EXISTS clause:DROP VIEW IF EXISTS v31;
См. также: DROP TABLE.
Синтаксис:
CREATE [UNIQUE] INDEX [IF NOT EXISTS] {index-name} ON {table-name} (column-list);
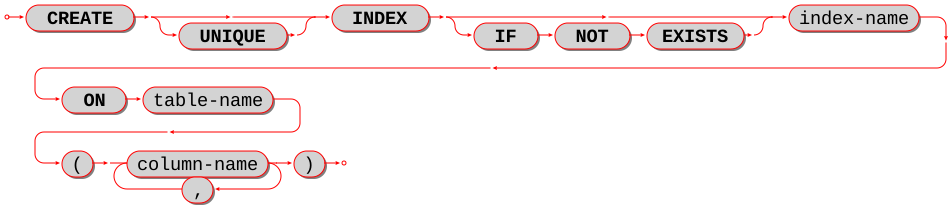
Создание индекса.
Имя index-name должно соответствовать правилам для идентификаторов.
Имя table-name должно ссылаться на существующую таблицу.
Список column-list должен представлять собой разделенный запятыми список имен колонок таблицы.
Правила:
- Для одной и той же таблицы не должно уже существовать индекса с тем же именем, что и index-name. Однако для другой таблицы может существовать индекс с тем же именем, что и index-name.
- Максимальное количество индексов для одной таблицы — 128. Действия:
- Tarantool выдаст ошибку при нарушении правила.
- Если новый индекс является UNIQUE, Tarantool выдаст ошибку при наличии строк с повторяющимися значениями в колонках.
- Tarantool создаст новый индекс.
- Обычно Tarantool фактически выполняет оператор COMMIT.
Автоматические индексы:
Индексы могут создаваться автоматически для колонок, указанных в предложениях PRIMARY KEY или UNIQUE оператора CREATE TABLE. Если индекс был создан автоматически, имя index-name состоит из четырех частей:
pk, если индекс создан для предложения PRIMARY KEY, илиunique, если для предложения UNIQUE;_unnamed_;- имя таблицы;
_и порядковый номер; для первого индекса — 1, для второго — 2 и так далее.
Например, после выполнения
CREATE TABLE t (s1 INTEGER PRIMARY KEY, s2 INTEGER, UNIQUE (s2));
создаются два индекса с именами pk_unnamed_T_1 и unique_unnamed_T_2.
Убедиться в этом можно, выполнив запрос SELECT * FROM "_index";,
который выведет список всех индексов всех таблиц. Нет необходимости
выполнять CREATE INDEX для колонок, для которых уже созданы
автоматические индексы.
Примеры:
-- the simple caseCREATE INDEX idx_column1_t_1 ON t (column1);-- with IF NOT EXISTS clauseCREATE INDEX IF NOT EXISTS idx_column1_t_1 ON t (column1);-- with UNIQUE specifier and more than one columnCREATE UNIQUE INDEX idx_unnamed_t_1 ON t (column1, column2);
Удаление автоматического индекса, созданного для ограничения уникальности, приведет также к удалению ограничения уникальности.
Синтаксис:
DROP INDEX [IF EXISTS] index-name ON {table-name};

index-name должно быть именем существующего индекса, созданного с помощью CREATE INDEX. Либо index-name должно быть именем индекса, созданного автоматически с помощью предложения PRIMARY KEY или UNIQUE в операторе CREATE TABLE. Чтобы просмотреть индексы таблицы, используйте PRAGMA index_list(table-name);.
Правила: отсутствуют
Действия:
- Tarantool выдает ошибку, если индекс не существует или является автоматически созданным индексом.
- Tarantool удаляет индекс.
- Обычно Tarantool фактически выполняет оператор COMMIT.
Пример:
-- the simplest form:DROP INDEX idx_unnamed_t_1 ON t;
Синтаксис:
CREATE TRIGGER [IF NOT EXISTS] {trigger-name}
BEFORE|AFTER|INSTEAD OF
DELETE|INSERT|UPDATE ON {table-name}
FOR EACH ROW
[WHEN search-condition]
BEGIN
delete-statement | insert-statement | replace-statement | select-statement | update-statement;
[delete-statement | insert-statement | replace-statement | select-statement | update-statement; ...]
END;
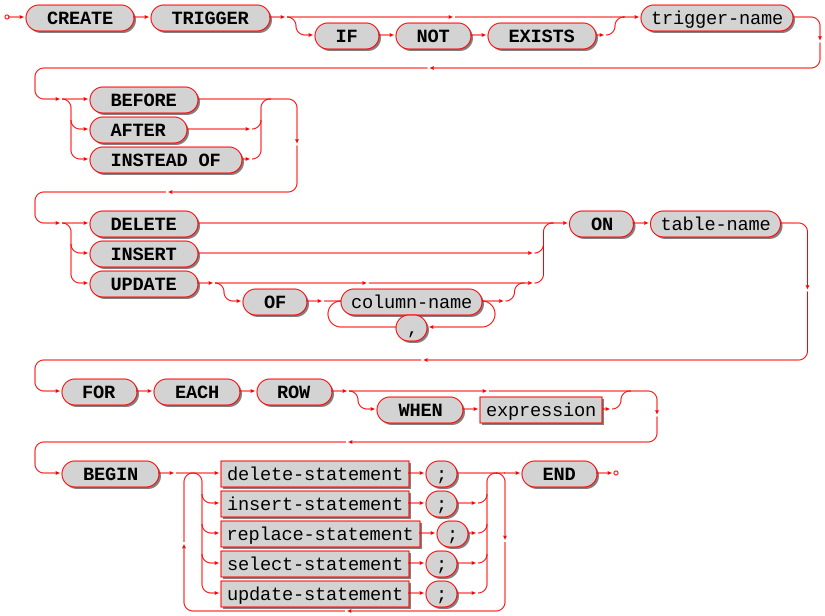
Имя trigger-name должно соответствовать правилам для идентификаторов.
Если время действия триггера — BEFORE или AFTER, то table-name должно ссылаться на существующую базовую таблицу.
Если время действия триггера — INSTEAD OF, то table-name должно ссылаться на существующее представление.
Правила:
- Триггер с тем же именем, что и trigger-name, не должен уже существовать.
- Триггеры для разных таблиц или представлений используют общее пространство имен.
- Операторы между BEGIN и END не должны ссылаться на table-name, указанный в предложении ON.
- Операторы между BEGIN и END не должны содержать предложение INDEXED BY.
SQL-триггеры не активируются запросами Tarantool/NoSQL. Это изменится в будущей версии.
На реплике применяются результаты выполнения триггеров, при этом сами SQL-триггеры не активируются при событиях репликации.
NoSQL-триггеры активируются как на реплике, так и на мастере, поэтому если на реплике есть NoSQL-триггер, он активируется при применении результатов SQL-триггера.
Действия:
- Tarantool выдаст ошибку при нарушении правила.
- Tarantool создаст новый триггер.
- Обычно Tarantool фактически выполняет оператор COMMIT.
Примеры:
-- the simple case:CREATE TRIGGER stores_before_insert BEFORE INSERT ON stores FOR EACH ROWBEGIN DELETE FROM warehouses; END;-- with IF NOT EXISTS clause:CREATE TRIGGER IF NOT EXISTS stores_before_insert BEFORE INSERT ON stores FOR EACH ROWBEGIN DELETE FROM warehouses; END;-- with FOR EACH ROW and WHEN clauses:CREATE TRIGGER stores_before_insert BEFORE INSERT ON stores FOR EACH ROW WHEN a=5BEGIN DELETE FROM warehouses; END;-- with multiple statements between BEGIN and END:CREATE TRIGGER stores_before_insert BEFORE INSERT ON stores FOR EACH ROWBEGIN DELETE FROM warehouses; INSERT INTO inventories VALUES (1); END;
-
UPDATE OF column-listПосле BEFORE|AFTER UPDATE можно добавить
OF column-list. Если в момент обработки строки затрагивается любой из колонок в column-list, триггер активируется для этой строки. Например:CREATE TRIGGER table1_before_updateBEFORE UPDATE OF column1, column2 ON table1FOR EACH ROWBEGIN UPDATE table2 SET column1 = column1 + 1; END;UPDATE table1 SET column3 = column3 + 1; -- Trigger will not be activatedUPDATE table1 SET column2 = column2 + 0; -- Trigger will be activated -
WHENПосле table-name FOR EACH ROW можно добавить [
WHEN expression]. Если в момент обработки строки выражение истинно, только тогда триггер активируется для этой строки. Например:CREATE TRIGGER table1_before_update BEFORE UPDATE ON table1 FOR EACH ROWWHEN (SELECT COUNT(*) FROM table1) > 1BEGIN UPDATE table2 SET column1 = column1 + 1; END;Этот триггер не активируется, если в
table1нет более одной строки. -
OLD and NEWКлючевые слова OLD и NEW имеют особое значение в контексте действия триггера:
-
OLD.column-name ссылается на значение column-name до изменения.
- NEW.column-name ссылается на значение column-name после изменения. Например:
CREATE TABLE table1 (column1 STRING, column2 INTEGER PRIMARY KEY);CREATE TABLE table2 (column1 STRING, column2 STRING, column3 INTEGER PRIMARY KEY);INSERT INTO table1 VALUES ('old value', 1);INSERT INTO table2 VALUES ('', '', 1);CREATE TRIGGER table1_before_update BEFORE UPDATE ON table1 FOR EACH ROWBEGIN UPDATE table2 SET column1 = old.column1, column2 = new.column1; END;UPDATE table1 SET column1 = 'new value';SELECT * FROM table2;
В начале UPDATE для единственной строки table1 значение в
column1 равно 'old value' — именно это значение доступно как
old.column1.
В конце UPDATE для единственной строки table1 значение в
column1 равно 'new value' — именно это значение доступно как
new.column1. (OLD и NEW являются квалификаторами для table1, а
не для table2.)
Таким образом, SELECT * FROM table2; возвращает
['old value', 'new value'].
OLD.column-name не существует для триггера INSERT.
NEW.column-name не существует для триггера DELETE.
OLD и NEW доступны только для чтения; их значения нельзя изменять.
- Устаревшие или недопустимые операторы:
Недопустимо, чтобы действие триггера включало квалифицированную ссылку
на колонку, отличную от OLD.column-name или NEW.column-name.
Например,
CREATE TRIGGER ... BEGIN UPDATE table1 SET table1.column1 = 5; END;
недопустимо.
Недопустимо, чтобы действие триггера включало операторы, содержащие предложение WITH, предложение DEFAULT VALUES или предложение INDEXED BY.
Обычно не рекомендуется создавать триггер на table1, вызывающий
изменение в table2, и одновременно триггер на table2, вызывающий
изменение в table1. Например:
CREATE TRIGGER table1_before_updateBEFORE UPDATE ON table1FOR EACH ROWBEGIN UPDATE table2 SET column1 = column1 + 1; END;CREATE TRIGGER table2_before_updateBEFORE UPDATE ON table2FOR EACH ROWBEGIN UPDATE table1 SET column1 = column1 + 1; END;
К счастью, UPDATE table1 ... не приведет к бесконечному циклу, так
как Tarantool распознает, что обновление уже было выполнено, и
остановится. Однако не каждая СУБД работает таким образом.
Ниже приведены замечания, касающиеся активации триггеров.
Стандартная терминология:
- "время действия триггера" (trigger action time) = BEFORE или AFTER или INSTEAD OF
- "событие триггера" (trigger event) = INSERT или DELETE или UPDATE
- "оператор триггера" (triggered statement) = BEGIN ... DELETEINSERTREPLACESELECTUPDATE ... END
- "условие триггера" (triggered when clause) = WHEN search-condition
- "активировать" (activate) = выполнить оператор триггера
- некоторые производители используют слово "fire" вместо "activate" Если для одного и того же события триггера существует более одного триггера, Tarantool может выполнять их в любом порядке.
Выполнение оператора триггера может привести к активации другого оператора триггера. Например, следующее допустимо:
CREATE TRIGGER t1_before_delete BEFORE DELETE ON t1 FOR EACH ROW BEGIN DELETE FROM t2; END;CREATE TRIGGER t2_before_delete BEFORE DELETE ON t2 FOR EACH ROW BEGIN DELETE FROM t3; END;
Активация происходит для каждой строки (FOR EACH ROW), а не для каждого оператора (FOR EACH STATEMENT). Поэтому если нет строк-кандидатов на вставку, обновление или удаление, триггеры не активируются.
Триггер BEFORE активируется даже в случае неудачного события триггера.
Если событие UPDATE не приводит к изменению, триггер все равно
активируется. Например, если в строке 1 column1 содержит 'a', а
событие триггера — UPDATE ... SET column1 = 'a';, триггер
активируется.
В операторе триггера может использоваться функция:
RAISE(FAIL, error-message). Если оператор триггера вызывает функцию
RAISE(FAIL, error-message) или приводит к ошибке, выполнение оператора
немедленно прекращается.
В операторе триггера могут использоваться значения колонок изменяемых строк. В этом случае:
- Строка "до изменения" называется "старой" строкой (old) (имеет смысл только для операторов UPDATE и DELETE).
- Строка "после изменения" называется "новой" строкой (new) (имеет смысл только для операторов UPDATE и INSERT).
В этом примере показано, как выполнить INSERT в представление, ссылаясь на "новую" строку:
CREATE TABLE t (s1 INTEGER PRIMARY KEY, s2 INTEGER);CREATE VIEW v AS SELECT s1, s2 FROM t;CREATE TRIGGER v_instead_of INSTEAD OF INSERT ON vFOR EACH ROWBEGIN INSERT INTO t VALUES (new.s1, new.s2); END;INSERT INTO v VALUES (1, 2);
Обычно выполнение INSERT INTO view_name ... недопустимо в Tarantool,
поэтому данный подход служит обходным путем.
Это можно обобщить так, чтобы все операторы изменения данных для представлений изменяли базовые таблицы — при условии, что представление содержит все колонки базовой таблицы и триггеры ссылаются на эти колонки там, где это необходимо, как в следующем примере:
CREATE TABLE base_table (primary_key_column INTEGER PRIMARY KEY, value_column INTEGER);CREATE VIEW viewed_table AS SELECT primary_key_column, value_column FROM base_table;CREATE TRIGGER viewed_table_instead_of_insert INSTEAD OF INSERT ON viewed_table FOR EACH ROWBEGININSERT INTO base_table VALUES (new.primary_key_column, new.value_column); END;CREATE TRIGGER viewed_table_instead_of_update INSTEAD OF UPDATE ON viewed_table FOR EACH ROWBEGINUPDATE base_tableSET primary_key_column = new.primary_key_column, value_column = new.value_columnWHERE primary_key_column = old.primary_key_column; END;CREATE TRIGGER viewed_table_instead_of_delete INSTEAD OF DELETE ON viewed_table FOR EACH ROWBEGINDELETE FROM base_table WHERE primary_key_column = old.primary_key_column; END;
При выполнении INSERT, UPDATE или DELETE для таблицы X Tarantool
обычно действует в следующем порядке (базовая схема):
For each rowPerform constraint checksFor each BEFORE trigger that refers to table XCheck that the trigger's WHEN condition is true.Execute what is in the triggered statement.Insert or update or delete the row in table X.Perform more constraint checksFor each AFTER trigger that refers to table XCheck that the trigger's WHEN condition is true.Execute what is in the triggered statement.
Однако Tarantool не гарантирует порядок выполнения при наличии
нескольких ограничений или нескольких триггеров для одного события
(включая NoSQL триггеры on_replace или SQL
триггеры INSTEAD OF, затрагивающие
представление таблицы X).
Максимальное количество активаций триггера на один оператор — 32.
Триггер, созданный с предложением
INSTEAD OF {INSERT|UPDATE|DELETE} ON {view-name}
является триггером INSTEAD OF. Для каждой затронутой
строки действие триггера выполняется "вместо" оператора INSERT, UPDATE
или DELETE, вызывающего активацию триггера.
Например, обычно недопустимо выполнять INSERT строк в представление, но допустимо создать триггер, который перехватывает попытки INSERT и помещает строки в базовую таблицу:
CREATE TABLE t1 (column1 INTEGER PRIMARY KEY, column2 INTEGER);CREATE VIEW v1 AS SELECT column1, column2 FROM t1;CREATE TRIGGER v1_instead_of INSTEAD OF INSERT ON v1 FOR EACH ROW BEGININSERT INTO t1 VALUES (NEW.column1, NEW.column2); END;INSERT INTO v1 VALUES (1, 1);-- ... The result will be: table t1 will contain a new row.
Триггеры INSTEAD OF допустимы только для представлений, а триггеры BEFORE или AFTER — только для базовых таблиц.
Допускается создание триггеров INSTEAD OF с предложениями WHEN в теле триггера.
Ограничения:
- Допускается создание триггеров INSTEAD OF с предложениями UPDATE OF column-list, но они не являются стандартным SQL.
Пример:
CREATE TRIGGER ev1_instead_of_updateINSTEAD OF UPDATE OF column2,column1 ON ev1FOR EACH ROW BEGININSERT INTO et2 VALUES (NEW.column1, NEW.column2); END;
Синтаксис:
DROP TRIGGER [IF EXISTS] {trigger-name};

Удаление триггера.
Имя trigger-name должно указывать на триггер, созданный ранее с помощью оператора CREATE TRIGGER.
Правила: отсутствуют
Действия:
- Tarantool возвращает ошибку, если триггер не существует и
отсутствует условие
IF EXISTS. - Триггер удаляется.
- Обычно Tarantool фактически выполняет оператор COMMIT.
Примеры:
-- the simple case:DROP TRIGGER table1_before_insert;-- with an IF EXISTS clause:DROP TRIGGER IF EXISTS table1_before_insert;
Синтаксис:
INSERT INTO {table-name} [(column-list)] VALUES (expression-list) [, (expression-list)];INSERT INTO {table-name} [(column-list)] select-statement;
INSERT INTO {table-name} DEFAULT VALUES;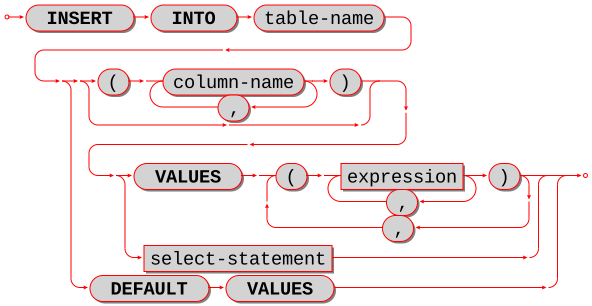
Добавляет одну или несколько новых строк в таблицу.
Имя table-name должно быть именем таблицы, ранее созданной с помощью CREATE TABLE.
Необязательный параметр column-list должен представлять собой разделенный запятыми список имен колонок таблицы.
Параметр expression-list должен представлять собой разделенный запятыми список выражений; каждое выражение может содержать литералы, операторы, подзапросы и вызовы функций.
Правила:
- Значения в expression-list вычисляются слева направо.
- Порядок значений в expression-list должен соответствовать порядку колонок в таблице или (если указан column-list) порядку колонок в column-list.
- Тип данных значения должен соответствовать типу данных колонки, то есть типу данных, указанному при создании таблицы с помощью CREATE TABLE.
- Если column-list не указан, количество выражений должно совпадать с количеством колонок в таблице.
- Если column-list указан, некоторые колонки можно опустить; для опущенных колонок будут использованы значения по умолчанию.
- Список expression-list в скобках может повторяться –
(expression-list),(expression-list),...– для добавления нескольких строк.
Действия:
- Tarantool вычисляет каждое выражение в expression-list и возвращает ошибку при нарушении любого из правил.
- Tarantool создает ноль или более новых строк со значениями, основанными на значениях из списка VALUES, на результатах select-expression или на значениях по умолчанию.
- Tarantool выполняет проверку ограничений, действия триггеров и фактическую вставку.
Примеры:
-- the simplest form:INSERT INTO table1 VALUES (1, 'A');-- with a column list:INSERT INTO table1 (column1, column2) VALUES (2, 'B');-- with an arithmetic operator in the first expression:INSERT INTO table1 VALUES (2 + 1, 'C');-- put two rows in the table:INSERT INTO table1 VALUES (4, 'D'), (5, 'E');
См. также: оператор REPLACE.
Синтаксис:
UPDATE {table-name} SET column-name = expression [, column-name = expression ...] [WHERE search-condition];
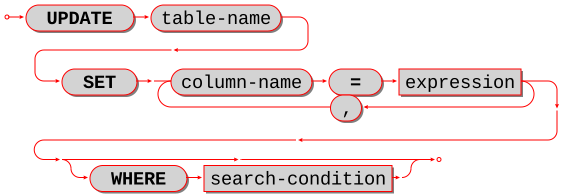
Обновление нуля или более существующих строк в таблице.
table-name должно быть именем таблицы, определенной ранее с помощью CREATE TABLE или CREATE VIEW.
column-name должно быть обновляемой колонкой в таблице.
expression может содержать литералы, операторы, подзапросы, вызовы функций и имена колонок.
Правила:
- Значения в предложении SET вычисляются слева направо.
- Тип данных значения должен соответствовать типу данных колонки, то есть типу данных, указанному при создании таблицы с помощью CREATE TABLE.
- Если search-condition не указано, будут обновлены все строки в таблице; в противном случае будут обновлены только те строки, которые соответствуют условию search-condition.
Действия:
- Tarantool вычисляет каждое выражение в предложении SET и возвращает ошибку при нарушении любого из правил. Для каждой строки, найденной по условию WHERE, формируется временная новая строка на основе исходного содержимого и изменений, внесенных предложением SET.
- Tarantool выполняет проверку ограничений, действия триггеров и фактическое обновление.
Примеры:
-- the simplest form:UPDATE t SET column1 = 1;-- with more than one assignment in the SET clause:UPDATE t SET column1 = 1, column2 = 2;-- with a WHERE clause:UPDATE t SET column1 = 5 WHERE column2 = 6;
Особые случаи:
Допускается использовать конструкцию SET (список колонок) = (список значений). Например:
UPDATE t SET (column1, column2, column3) = (1, 2, 3);
Нельзя присваивать значение колонке более одного раза. Например:
INSERT INTO t (column1) VALUES (0);UPDATE t SET column1 = column1 + 1, column1 = column1 + 1;
Результат — ошибка: "duplicate column name".
Нельзя присваивать значение колонке первичного ключа.
Синтаксис:
DELETE FROM {table-name} [WHERE search-condition];

Удаляет ноль или более существующих строк в таблице.
Имя table-name должно быть именем таблицы, определенной ранее с помощью CREATE TABLE или CREATE VIEW.
Условие search-condition может содержать литералы, операторы, подзапросы, вызовы функций и имена колонок.
Правила:
- Если условие поиска не указано, будут удалены все строки в таблице; в противном случае будут удалены только те строки, которые соответствуют условию search-condition.
Действия:
- Tarantool вычисляет каждое выражение в условии search-condition и возвращает ошибку, если нарушено какое-либо правило.
- Tarantool находит набор строк, подлежащих удалению.
- Tarantool выполняет проверки ограничений, действия триггеров и само удаление.
Примеры:
-- the simplest form:DELETE FROM t;-- with a WHERE clause:DELETE FROM t WHERE column2 = 6;
Синтаксис:
REPLACE INTO {table-name} [(column-list)] VALUES (expression-list) [, (expression-list)];REPLACE INTO {table-name} [(column-list)] select-statement;
REPLACE INTO {table-name} DEFAULT VALUES;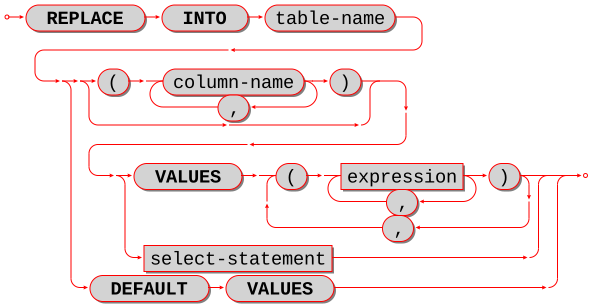
Добавляет одну или несколько новых строк в таблицу или обновляет существующие строки.
Если строка уже существует (это определяется по первичному ключу или любому уникальному ключу), то выполняется удаление и вставка, и применяются те же правила, что и для оператора DELETE, за которым следует оператор INSERT. В противном случае выполняется вставка, и применяются те же правила, что и для оператора INSERT.
Примеры:
-- the simplest form:REPLACE INTO table1 VALUES (1, 'A');-- with a column list:REPLACE INTO table1 (column1, column2) VALUES (2, 'B');-- with an arithmetic operator in the first expression:REPLACE INTO table1 VALUES (2 + 1, 'C');-- put two rows in the table:REPLACE INTO table1 VALUES (4, 'D'), (5, 'E');
См. также: оператор INSERT, оператор UPDATE.
Синтаксис:
TRUNCATE TABLE {table-name};

Удаляет все строки в таблице.
TRUNCATE считается оператором изменения схемы, а не изменения данных, поэтому он не работает внутри транзакций (его нельзя откатить).
Правила:
- Недопустимо очищать таблицу, на которую ссылается внешний ключ.
- Недопустимо очищать таблицу, которая также является системным спейсом,
например
_space.
- Таблица должна быть базовой, а не представлением. Действия:
- Все строки в таблице удаляются. Обычно это быстрее, чем
DELETE FROM {table-name};. - Если у таблицы есть автоинкрементный первичный ключ, её sequence не сбрасывается в ноль, но это может измениться в будущих версиях Tarantool.
- На триггеры, связанные с таблицей, это не влияет.
- На счётчик функции
ROW_COUNT()это не влияет. - В журнал предзаписи записывается только одно
действие (при использовании
DELETE FROM {table-name};было бы по одному действию на каждую удалённую строку).
Пример:
TRUNCATE TABLE t;
Синтаксис:
*SET SESSION {setting-name} = {setting-value};

SET SESSION — это краткий способ обновления временного системного спейса box.space._session_settings.
Для setting-name допустимы следующие значения:
"sql_default_engine""sql_full_column_names""sql_full_metadata""sql_parser_debug""sql_recursive_triggers""sql_reverse_unordered_selects""sql_select_debug""sql_vdbe_debug""sql_defer_foreign_keys"(удалено в 2.11.0)
"error_marshaling_enabled"(удалено в 2.10.0) Кавычки обязательны.
Если setting-name — "sql_default_engine", то setting-value может
принимать значение 'vinyl' или 'memtx'. В остальных случаях
setting-value может принимать значение TRUE или FALSE.
Пример: SET SESSION "sql_default_engine" = 'vinyl'; изменяет движок по
умолчанию на 'vinyl' вместо 'memtx' и возвращает:
---
- row_count: 1
Функционально это то же самое, что и оператор UPDATE:
UPDATE "_session_settings"SET "value" = 'vinyl'WHERE "name" = 'sql_default_engine';
Синтаксис:
SELECT [ALL|DISTINCT] select list [from clause] [where clause] [group-by clause] [having clause] [order-by clause];
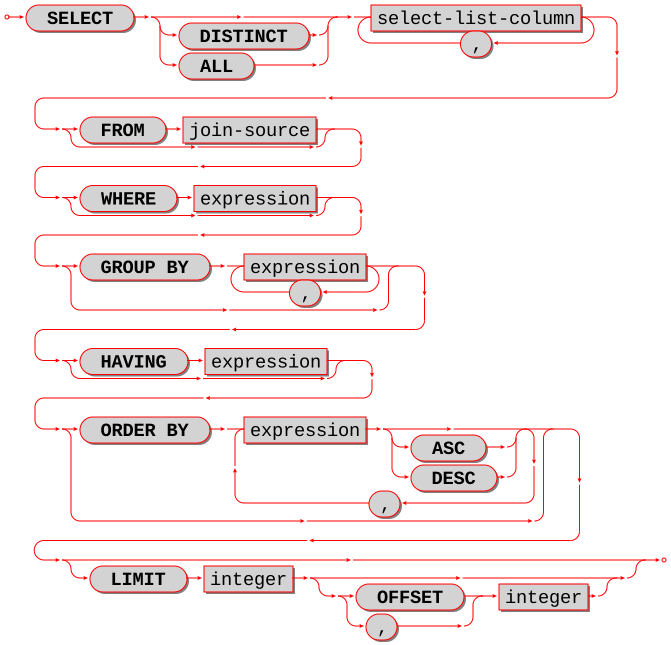
Выбор нуля или более строк.
Описания предложений инструкции SELECT приведены в следующих пяти разделах.
Синтаксис:
select-list-column [, select-list-column ...]
select-list-column:
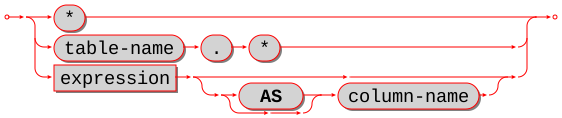
Определяет содержимое результирующего набора; это предложение в инструкции SELECT.
Список выбора (select list) — это разделенный запятыми список
выражений или * (звездочка). Выражение может иметь псевдоним, заданный
с помощью предложения [[AS] column-name].
Сокращение * («звездочка») допустимо только в том случае, если
инструкция SELECT также содержит предложение FROM,
указывающее таблицу или таблицы (подробнее о предложении FROM — в
следующем разделе). Простая форма — * — означает «все колонки».
Например, если выборка выполняется из таблицы, содержащей три колонки
s1 s2 s3, то SELECT * ... эквивалентно SELECT s1, s2, s3 ....
Квалифицированная форма — table-name.* — означает «все колонки в
указанной таблице», которая также должна быть результатом предложения
FROM. Например, если таблица называется table1, то table1.*
эквивалентно списку колонок таблицы table1.
Предложение [[AS] column-name] определяет имя колонки. Имя колонки
полезно по двум причинам:
- при табличном отображении имена колонок используются в качестве заголовков;
- если результаты SELECT используются при создании новой таблицы (например, представления), то именами колонок в новой таблице будут имена колонок из списка выбора.
Если [[AS] column-name] отсутствует, а выражение не является просто
именем колонки в таблице, то Tarantool формирует имя
COLUMN_{n}, где {n} — порядковый номер выражения, не являющегося простым
именем колонки, в списке выбора. Например,
SELECT 5.88, table1.x, 'b' COLLATE "unicode_ci" FROM table1; приведет
к тому, что именами колонок станут COLUMN_1, X, COLUMN_2. Это изменение
поведения по сравнению с версией
2.5.1. В более ранних
версиях имя было бы равно выражению; см.
Issue#3962.
Создавать таблицы с именами колонок вроде COLUMN_1 по-прежнему
допустимо, но не рекомендуется.
Примеры:
-- the simple form:SELECT 5;-- with multiple expressions including operators:SELECT 1, 2 * 2, 'Three' || 'Four';-- with [[AS] column-name] clause:SELECT 5 AS column1;-- * which must be eventually followed by a FROM clause:SELECT * FROM table1;-- as a list:SELECT 1 AS a, 2 AS b, table1.* FROM table1;
Синтаксис:
FROM [SEQSCAN] table-reference [, table-reference ...]
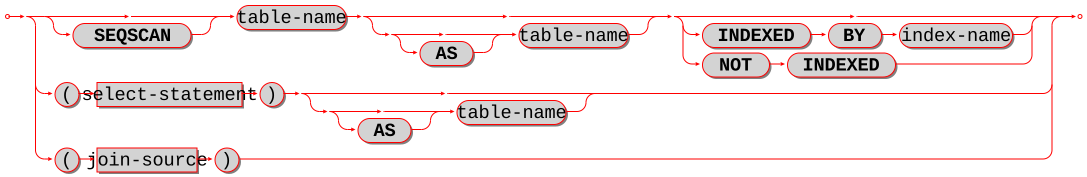
Указывает таблицу или таблицы, выступающие источником данных для инструкции SELECT.
Ссылка на таблицу (table-reference) должна быть именем существующей таблицы, подзапросом или соединенной таблицей.
Соединенная таблица выглядит так:
table-reference-or-joined-table join-operator table-reference-or-joined-table [join-specification]
Оператор соединения (join-operator) должен быть одним из стандартных типов:
- [NATURAL] LEFT [OUTER] JOIN,
- [NATURAL] INNER JOIN, или
- CROSS JOIN Спецификация соединения (join-specification) должна быть одной из:
- ON expression, или
- USING (column-name [, column-name ...]) Скобки разрешены, также
разрешено использование
[[AS] correlation-name].
Максимальное количество соединений в предложении FROM — 64.
Ключевое слово SEQSCAN (начиная с
2.11) помечает
запросы, которые выполняют последовательное сканирование. Это
происходит, если запрос не может использовать индексы и проходит по всем
строкам таблицы одну за другой, что иногда вызывает высокую нагрузку.
Такие запросы называются запросами со сканированием. Если в запросе со
сканированием отсутствует ключевое слово SEQSCAN, Tarantool выдает
ошибку. SEQSCAN должен предшествовать всем именам таблиц, которые
сканируются в запросе.
Чтобы определить, выполняет ли запрос последовательное сканирование,
используйте EXPLAIN QUERY PLAN. Для запросов со сканированием
результат содержит SCAN TABLE table_name.
Примеры:
-- the simplest form:SELECT * FROM SEQSCAN t;-- with two tables, making a Cartesian join:SELECT * FROM SEQSCAN t1, SEQSCAN t2;-- with one table joined to itself, requiring correlation names:SELECT a.*, b.* FROM SEQSCAN t1 AS a, SEQSCAN t1 AS b;-- with a left outer join:SELECT * FROM SEQSCAN t1 LEFT JOIN SEQSCAN t2;
Синтаксис:
WHERE condition;
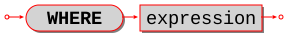
Задает условие для фильтрации строк таблицы; это предложение в инструкции SELECT, UPDATE или DELETE.
Условие может содержать любое выражение, возвращающее значение типа BOOLEAN (TRUE, FALSE или UNKNOWN).
Для каждой строки в таблице:
- если условие истинно, строка сохраняется;
- если условие ложно или неизвестно, строка игнорируется. Таким образом, условие WHERE принимает таблицу с n строками и возвращает таблицу с n или меньшим количеством строк.
Примеры:
-- with a simple condition:SELECT 1 FROM t WHERE column1 = 5;-- with a condition that contains AND and OR and parentheses:SELECT 1 FROM t WHERE column1 = 5 AND (x > 1 OR y < 1);
Синтаксис:
GROUP BY expression [, expression ...]
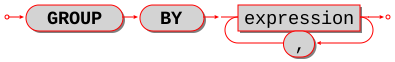
Формирует сгруппированную таблицу; это предложение в инструкции SELECT.
Выражения должны быть именами колонок таблицы, и каждая колонка должна быть указан только один раз.
Таким образом, предложение GROUP BY принимает таблицу со строками, которые могут содержать совпадающие значения, объединяет строки с совпадающими значениями в отдельные строки и возвращает таблицу, которая называется сгруппированной, так как является результатом GROUP BY.
Таким образом, если на входе таблица:
a b c- - -1 'a' 'b'1 'b' 'b'2 'a' 'b'3 'a' 'b'
Строки с одинаковыми значениями в колонках a и b объединены; колонка
c сохранена, но на её значение не следует полагаться — если бы
значения в строках не были равны 'b', Tarantool мог бы выбрать любое
из них.
Полезно представлять сгруппированную таблицу как имеющую скрытые дополнительные колонки для агрегации значений, например:
a b c COUNT(a) SUM(a) MIN(c)- - - -------- ------ ------1 'a' 'b' 2 2 'b'1 'b' 'b' 1 1 'b'2 'a' 'b' 1 2 'b''a' 'b' 1 3 'b'
Для работы с этими дополнительными колонками предназначены агрегатные функции.
Примеры:
-- with a single column:SELECT 1 FROM t GROUP BY column1;-- with two columns:SELECT 1 FROM t GROUP BY column1, column2;
Ограничения:
-
SELECT s1, s2 FROM t GROUP BY s1;допустимо. -
SELECT s1 AS q FROM t GROUP BY q;допустимо. -
SELECT s1 FROM t GROUP by 1;допустимо.
Синтаксис:
function-name (one or more expressions)
Применяет встроенную агрегатную функцию к одному или нескольким выражениям и возвращает скалярное значение.
Агрегатные функции допустимы только в определенных предложениях
инструкции SELECT для сгруппированных таблиц. (Таблица
является сгруппированной, если присутствует предложение GROUP BY.) Кроме
того, если агрегатная функция используется в
списке выбора, а предложение GROUP BY опущено, то
Tarantool предполагает SELECT ... GROUP BY [all columns];.
Значения NULL игнорируются всеми агрегатными функциями, кроме COUNT(*).
AVG([DISTINCT] expression)
: Возвращает среднее значение выражения.
Пример: `AVG({column1})`
COUNT([DISTINCT] expression)
: Возвращает количество вхождений выражения.
Пример: `COUNT({column1})`
COUNT(*)
: Возвращает количество строк.
Пример: `COUNT(*)`
GROUP_CONCAT(expression-1 [, expression-2]) или GROUP_CONCAT(DISTINCT expression-1)
: Возвращает список значений expression-1, разделенных запятыми, если expression-2 опущено, или разделенных значением expression-2, если оно указано.
Пример: `GROUP_CONCAT({column1})`
MAX([DISTINCT] expression)
: Возвращает максимальное значение выражения.
Пример: `MAX({column1})`
MIN([DISTINCT] expression)
: Возвращает минимальное значение выражения.
Пример: `MIN({column1})`
SUM([DISTINCT] expression)
: Возвращает сумму значений выражения или NULL, если строк не было.
Пример: `SUM({column1})`
TOTAL([DISTINCT] expression)
: Возвращает сумму значений выражения или ноль, если строк не было.
Пример: `TOTAL({column1})`
Синтаксис:
HAVING condition;
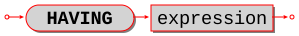
Задает условие для фильтрации строк сгруппированной таблицы; это предложение в инструкции SELECT.
Предложением, предшествующим HAVING, может быть GROUP BY. HAVING обрабатывает таблицу, созданную предложением GROUP BY, которая может содержать сгруппированные колонки и агрегаты.
Если предшествующее предложение не является GROUP BY, то существует только одна группа, и предложение HAVING может содержать только агрегатные функции или литералы.
Для каждой строки в таблице:
- если условие истинно, строка сохраняется;
- если условие ложно или неизвестно, строка игнорируется. Таким образом, условие HAVING принимает таблицу с n строками и возвращает таблицу с n или меньшим количеством строк.
Примеры:
-- with a simple condition:SELECT 1 FROM t GROUP BY column1 HAVING column2 > 5;-- with a more complicated condition:SELECT 1 FROM t GROUP BY column1 HAVING column2 > 5 OR column2 < 5;-- with an aggregate:SELECT x, SUM(y) FROM t GROUP BY x HAVING SUM(y) > 0;-- with no GROUP BY and an aggregate:SELECT SUM(y) FROM t GROUP BY x HAVING MIN(y) < MAX(y);
Ограничения:
- HAVING без GROUP BY не поддерживается для нескольких таблиц.
Синтаксис:
ORDER BY expression [ASC|DESC] [, expression [ASC|DESC] ...]
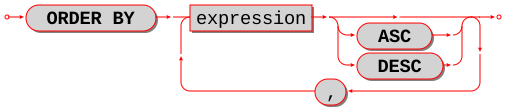
Упорядочивает строки; это предложение в инструкции SELECT.
Выражение ORDER BY относится к одному из трех типов, которые проверяются по порядку:
- Выражение является положительным целым числом, представляющим
порядковый номер колонки в списке выбора.
Например, в инструкции
SELECT x, y, z FROM t ORDER BY 2;ORDER BY 2означает «упорядочить по второй колонке в списке выбора», то есть поy. - Выражение является именем колонки в списке выбора, заданным с
помощью предложения AS. Например, в инструкции
SELECT x, y AS x, z FROM t ORDER BY x;
ORDER BY xозначает «упорядочить по колонке, явно названномуxв списке выбора», то есть по второй колонке. - Выражение содержит имя колонки в таблице из предложения FROM.
Например, в инструкции
SELECT x, y FROM t1 JOIN t2 ORDER BY z;
ORDER BY zозначает «упорядочить по колонке с именемz, который ожидается в таблицеt1или таблицеt2".
Если обе таблицы содержат колонку с именем z, Tarantool выберет первую
найденную колонку.
Выражение может содержать операторы и имена функций, а также конкретные
значения. Например, в инструкции SELECT x, y FROM t ORDER BY UPPER(z);
часть ORDER BY UPPER(z) означает "упорядочить по значениям колонки
t.z, представленным в заглавном регистре". Вероятно, эта операция
аналогична упорядочиванию с помощью одной из нечувствительных к регистру
сортировок Tarantool.
Тип 3 недопустим, если инструкция SELECT содержит UNION, EXCEPT или INTERSECT.
Если предложение ORDER BY содержит несколько выражений, то сначала
обрабатываются выражения слева, а выражения справа обрабатываются только
при необходимости разрешения совпадений. Например, в инструкции
SELECT x, y FROM t ORDER BY x, y; если есть две строки с одинаковыми
значениями в колонке x, то выполняется дополнительная проверка, чтобы
определить, в какой строке значение колонки y больше.
Таким образом, предложение ORDER BY принимает таблицу с неупорядоченными строками и возвращает таблицу с упорядоченными строками.
Порядок сортировки:
- По умолчанию используется порядок ASC (по возрастанию), альтернативный — DESC (по убыванию).
- Сначала идут значения NULL, затем BOOLEAN, затем числовые типы, затем STRING, затем VARBINARY, затем UUID.
- Порядок не имеет значения для ARRAY, MAP или ANY, так как они не поддерживают сравнение.
- В пределах STRING упорядочивание выполняется в соответствии с правилами сортировки.
- Правила сортировки могут быть заданы с помощью предложения COLLATE в списке колонок ORDER BY или использоваться по умолчанию. Примеры:
-- with a single column:SELECT 1 FROM t ORDER BY column1;-- with two columns:SELECT 1 FROM t ORDER BY column1, column2;-- with a variety of data:CREATE TABLE h (s1 NUMBER PRIMARY KEY, s2 SCALAR);INSERT INTO h VALUES (7, 'A'), (4, 'a'), (-4, 'AZ'), (17, 17), (23, NULL);INSERT INTO h VALUES (17.5, 'Д'), (1e+300, 'A'), (0, ''), (-1, '');SELECT * FROM h ORDER BY s2 COLLATE "unicode_ci", s1;-- The result of the above SELECT will be:- - [23, null]- [17, 17]- [-1, '']- [0, '']- [4, 'a']- [7, 'A']- [1e+300, 'A']- [-4, 'AZ']- [17.5, 'Д']...
Ограничения:
- ORDER BY 1 допустимо. Это распространенный прием, но он не соответствует современному стандарту SQL.
Синтаксис:
LIMIT limit-expression [OFFSET offset-expression]LIMIT offset-expression, limit-expression
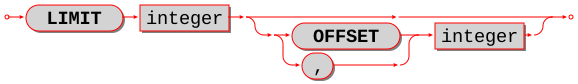
Задает максимальное количество строк и начальную строку; это предложение в инструкции SELECT.
Выражения могут содержать целые числа, арифметические операторы или
функции, например ABS(-3 / 1). Однако результат должен быть целым
числом, большим или равным нулю.
Обычно предложение LIMIT следует за предложением ORDER BY, так как в противном случае Tarantool не гарантирует порядок строк.
Примеры:
-- simple case:SELECT * FROM t LIMIT 3;-- both limit and order:SELECT * FROM t LIMIT 3 OFFSET 1;-- applied to a UNIONed result (LIMIT clause must be the final clause):SELECT column1 FROM table1 UNION SELECT column1 FROM table2 ORDER BY 1 LIMIT 1;
Ограничения:
- При использовании ORDER BY ... LIMIT все колонки сортировки должны быть либо ASC, либо DESC.
Синтаксис:
- Синтаксис инструкции SELECT
- Синтаксис инструкции VALUES Подзапрос имеет тот же синтаксис, что и встроенная в основную инструкцию инструкция SELECT или инструкция VALUES.
Подзапросы могут быть второй частью инструкций INSERT. Например:
INSERT INTO t2 SELECT a, b, c FROM t1;
Подзапросы могут использоваться в предложении FROM инструкций SELECT.
Подзапросы могут быть выражениями или частью выражений. В этом случае они должны быть заключены в скобки, и обычно количество строк должно быть равно 1. Например:
SELECT 1, (SELECT 5), 3 FROM t WHERE c1 * (SELECT COUNT(*) FROM t2) > 5;
Подзапросы могут быть выражениями в правой части определенных операторов сравнения, и в этом случае количество строк может быть больше 1. Такими операторами сравнения являются: [NOT] EXISTS и [NOT] IN. Например:
DELETE FROM t WHERE s1 NOT IN (SELECT s2 FROM t);
Подзапросы могут ссылаться на значения из внешнего запроса. В этом случае подзапрос называется «коррелированным подзапросом».
Подзапросы могут ссылаться на строки, которые обновляются или удаляются основным запросом. В этом случае подзапрос сначала находит соответствующие строки, прежде чем начать обновление или удаление. Например, после:
CREATE TABLE t (s1 INTEGER PRIMARY KEY, s2 INTEGER);INSERT INTO t VALUES (1, 3), (2, 1);DELETE FROM t WHERE s2 NOT IN (SELECT s1 FROM t);
будет удалена только одна строка, а не обе.
Предложение WITH (табличное выражение)
Синтаксис:
WITH {temporary-table-name} AS (subquery)
[, {temporary-table-name} AS (subquery)]
SELECT statement | INSERT statement | DELETE statement | UPDATE statement | REPLACE statement;

WITH v AS (SELECT * FROM t) SELECT * FROM v;
эквивалентно созданию представления и выборке из него:
CREATE VIEW v AS SELECT * FROM t;SELECT * FROM v;
Отличие в том, что «представление» предложения WITH является временным и используется только в пределах одной инструкции. Привилегия CREATE не требуется.
Предложение WITH также можно рассматривать как подзапрос с именем. Это полезно, когда один и тот же подзапрос повторяется. Например:
SELECT * FROM t WHERE a < (SELECT s1 FROM x) AND b < (SELECT s1 FROM x);
можно заменить на:
WITH s AS (SELECT s1 FROM x) SELECT * FROM t,s WHERE a < s.s1 AND b < s.s1;
Такое «вынесение» повторяющегося выражения считается хорошей практикой.
Примеры:
WITH cte AS (VALUES (7, '') INSERT INTO j SELECT * FROM cte;WITH cte AS (SELECT s1 AS x FROM k) SELECT * FROM cte;WITH cte AS (SELECT COUNT(*) FROM k WHERE s2 < 'x' GROUP BY s3)UPDATE j SET s2 = 5WHERE s1 = (SELECT s1 FROM cte) OR s3 = (SELECT s1 FROM cte);
WITH может использоваться только в начале инструкции, поэтому его нельзя использовать в начале подзапроса, после оператора объединения или внутри инструкции CREATE.
«Представление» предложения WITH доступно только для чтения, так как Tarantool не поддерживает обновляемые представления.
Предложение WITH RECURSIVE (итеративное табличное выражение)
Главная сила WITH заключается в предложении WITH RECURSIVE, которое полезно при совместном использовании с UNION или UNION ALL:
WITH RECURSIVE recursive-table-name AS
(SELECT ... FROM non-recursive-table-name ...
UNION [ALL]
SELECT ... FROM recursive-table-name ...)
statement-that-uses-recursive-table-name;
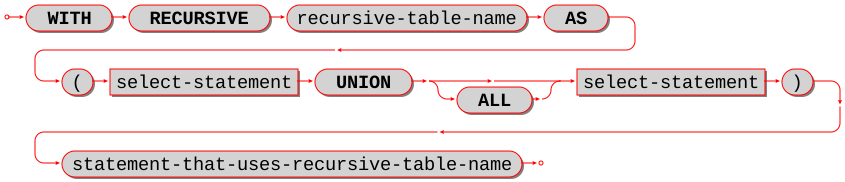
На не-SQL языке это можно прочитать так: начиная с начального значения из нерекурсивной таблицы, создается рекурсивное представление, которое объединяется само с собой, затем снова объединяется само с собой, и так далее — бесконечно, или пока условие в предложении WHERE не скажет «стоп».
Пример:
CREATE TABLE ts (s1 INTEGER PRIMARY KEY);INSERT INTO ts VALUES (1);WITH RECURSIVE w AS (SELECT s1 FROM tsUNION ALLSELECT s1 + 1 FROM w WHERE s1 < 4)SELECT * FROM w;
Сначала таблица w заполняется из t1, поэтому она содержит одну
строку: [1].
Затем UNION ALL (SELECT s1 + 1 FROM w) берет строку из w —
содержащую [1] — добавляет 1, так как в списке выбора указано
«s1+1», и получает одну строку: [2].
Затем UNION ALL (SELECT s1 + 1 FROM w) берет строку из w —
содержащую [2] — добавляет 1, так как в списке выбора указано
«s1+1», и получает одну строку: [3].
Затем UNION ALL (SELECT s1 + 1 FROM w) берет строку из w —
содержащую [3] — добавляет 1, так как в списке выбора указано
«s1+1», и получает одну строку: [4].
Затем UNION ALL (SELECT s1 + 1 FROM w) берет строку из w —
содержащую [4] — и здесь становится очевидной важность предложения
WHERE, так как условие «s1 < 4» ложно для этой строки, и поэтому
достигнуто условие остановки.
Таким образом, перед остановкой таблица w получила 4 строки — [1],
[2], [3], [4] — и результат инструкции выглядит так:
tarantool> WITH RECURSIVE w AS (> SELECT s1 FROM ts> UNION ALL> SELECT s1 + 1 FROM w WHERE s1 < 4)> SELECT * FROM w;---- - [1]- [2]- [3]- [4]...
Иными словами, этот запрос WITH RECURSIVE ... SELECT создает таблицу с
автоинкрементными значениями.
Синтаксис:
select-statement UNION [ALL] select-statement [ORDER BY clause] [LIMIT clause];select-statement EXCEPT select-statement [ORDER BY clause] [LIMIT clause];
select-statement INTERSECT select-statement [ORDER BY clause] [LIMIT clause];



UNION, EXCEPT и INTERSECT вместе называются «операторами над множествами» или «операторами над таблицами». А именно:
a UNION bозначает «взять строки, которые встречаются в a ИЛИ b».a EXCEPT bозначает «взять строки, которые встречаются в a И НЕ в b».
a INTERSECT bозначает «взять строки, которые встречаются в a И b». Повторяющиеся строки исключаются, если не указано ALL.
Инструкции select-statement могут быть объединены в цепочку:
SELECT ... SELECT ... SELECT ...;
Каждая инструкция select-statement должна возвращать одинаковое количество колонок.
Инструкции select-statement могут быть заменены на инструкции VALUES.
Максимальное количество операций над множествами — 50.
Пример:
CREATE TABLE t1 (s1 INTEGER PRIMARY KEY, s2 STRING);CREATE TABLE t2 (s1 INTEGER PRIMARY KEY, s2 STRING);INSERT INTO t1 VALUES (1, 'A'), (2, 'B'), (3, NULL);INSERT INTO t2 VALUES (1, 'A'), (2, 'C'), (3,NULL);SELECT s2 FROM t1 UNION SELECT s2 FROM t2;SELECT s2 FROM t1 UNION ALL SELECT s2 FROM t2 ORDER BY s2;SELECT s2 FROM t1 EXCEPT SELECT s2 FROM t2;SELECT s2 FROM t1 INTERSECT SELECT s2 FROM t2;
В данном примере:
- Запрос UNION возвращает 4 строки: NULL, 'A', 'B', 'C'.
- Запрос UNION ALL возвращает 6 строк: NULL, NULL, 'A', 'A', 'B', 'C'.
- Запрос EXCEPT возвращает 1 строку: 'B'.
- Запрос INTERSECT возвращает 2 строки: NULL, 'A'. Ограничения:
- Использование скобок не допускается.
- Вычисление выполняется слева направо, INTERSECT не имеет приоритета. Пример:
CREATE TABLE t01 (s1 INTEGER PRIMARY KEY, s2 STRING);CREATE TABLE t02 (s1 INTEGER PRIMARY KEY, s2 STRING);CREATE TABLE t03 (s1 INTEGER PRIMARY KEY, s2 STRING);INSERT INTO t01 VALUES (1, 'A');INSERT INTO t02 VALUES (1, 'B');INSERT INTO t03 VALUES (1, 'A');SELECT s2 FROM t01 INTERSECT SELECT s2 FROM t03 UNION SELECT s2 FROM t02;SELECT s2 FROM t03 UNION SELECT s2 FROM t02 INTERSECT SELECT s2 FROM t03;-- ... results are different.
Синтаксис:
INDEXED BY {index-name}

Оператор INDEXED BY может использоваться в инструкциях SELECT, DELETE или UPDATE сразу после table-name. Например:
DELETE FROM table7 INDEXED BY index7 WHERE column1 = 'a';
В этом случае поиск значения 'a' будет выполняться в пределах
index7. Например:
SELECT * FROM table7 NOT INDEXED WHERE column1 = 'a';
В этом случае поиск значения 'a' будет выполняться путем сканирования
всей таблицы — это иногда называется «полным сканированием таблицы»
(full table scan), даже если для column1 существует индекс.
Как правило, Tarantool выбирает подходящий индекс или метод поиска на основе сложного набора правил «оптимизатора»; оператор INDEXED BY переопределяет выбор оптимизатора. Если для индекса был задан параметр exclude_null, он будет использоваться только при явном указании пользователем.
Пример:
Предположим, у таблицы есть два колонки:
- Первая колонка является первичным ключом, и поэтому для неё
автоматически создается индекс с именем
pk_unnamed_T_1.
- Для второй колонки пользователем создан индекс. Пользователь
выполняет выборку с
INDEXED BY the-index-on-column1, а затем сINDEXED BY the-index-on-column-2.
CREATE TABLE t (column1 INTEGER PRIMARY KEY, column2 INTEGER);CREATE INDEX idx_column2_t_1 ON t (column2);INSERT INTO t VALUES (1, 2), (2, 1);SELECT * FROM t INDEXED BY "pk_unnamed_T_1";SELECT * FROM t INDEXED BY idx_column2_t_1;-- Result for the first select: (1, 2), (2, 1)-- Result for the second select: (2, 1), (1, 2).
Ограничения:
Часто INDEXED BY не оказывает никакого влияния.
Часто
INDEXED BY влияет на выбор покрывающего индекса, но не на условие WHERE.
Синтаксис:
VALUES (expression [, expression ...]) [, (expression [, expression ...])
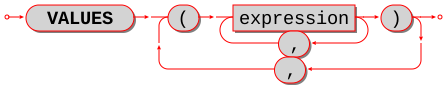
Выбор одной или нескольких строк.
Инструкция VALUES выполняет то же действие, что и SELECT, то есть возвращает результирующую выборку, однако в инструкциях VALUES не могут использоваться предложения FROM, GROUP, ORDER BY или LIMIT.
VALUES может использоваться везде, где допустимо использование SELECT, например в подзапросах.
Примеры:
-- simple case:VALUES (1);-- equivalent to SELECT 1, 2, 3:VALUES (1, 2, 3);-- two rows:VALUES (1, 2, 3), (4, 5, 6);
Синтаксис:
PRAGMA {pragma-name} (pragma-value);- или
PRAGMA {pragma-name};

Операторы PRAGMA предоставляют базовую информацию о «метаданных» базы данных или производительности сервера, хотя для получения метаданных лучше использовать системные таблицы.
Для операторов PRAGMA, содержащих (pragma-value), значения прагмы
представляют собой строки и могут быть указаны в двойных кавычках ""
или без них. Если строка используется для поиска, результаты должны
совпадать в соответствии с бинарной сортировкой. Если имя искомого
объекта написано в нижнем регистре, используйте двойные кавычки.
В более ранней версии существовали операторы PRAGMA, определяющие поведение. Сейчас это не так. Изменение поведения выполняется путем обновления системной таблицы box.space._session_settings.
Pragma Parameter Effect
foreign_key_list string
table-name Возвращает результирующий набор данных с одной строкой для каждого внешнего ключа таблицы "table-name". Каждая строка содержит:
(INTEGER) id – идентификационный номер
(INTEGER) seq – порядковый номер
(STRING) table – имя таблицы
(STRING) from – ссылающийся ключ
(STRING) to – ссылаемый ключ
(STRING) on_update – предложение ON UPDATE
(STRING) on_delete – предложение ON DELETE
(STRING) match – предложение MATCH
Системная таблица — "_fk_constraint".
collation_list Возвращает результирующий набор данных с одной строкой для каждого поддерживаемого правила сортировки. Первые четыре правила сортировки — 'none', 'unicode', 'unicode_ci' и 'binary', затем следуют около 270 предопределённых правил сортировки; точное количество может меняться, так как пользователи могут добавлять собственные правила сортировки.
Системная таблица — "_collation".
index_info string
table-name . index-name Возвращает результирующий набор данных с одной строкой для каждой колонки в "table-name.index-name". Каждая строка содержит:
(INTEGER) seqno – порядковый номер колонки в индексе (первая колонка — 0)
(INTEGER) cid – порядковый номер колонки в таблице (первая колонка — 0)
(STRING) name – имя колонки
(INTEGER) desc – 0 означает ASC, 1 означает DESC
(STRING) имя правила сортировки
(STRING) type – тип данных
index_list string
table-name Возвращает результирующий набор данных с одной строкой для каждого индекса таблицы "table-name". Каждая строка содержит:
(INTEGER) seq – порядковый номер
(STRING) name – имя индекса
(INTEGER) unique – указывает, является ли индекс уникальным: 0 — нет, 1 — да
Системная таблица — "_index".
stats Возвращает результирующий набор данных с одной строкой для каждого индекса каждой таблицы. Каждая строка содержит:
(STRING) table – имя таблицы
(STRING) index – имя индекса
(INTEGER) width – произвольная информация
(INTEGER) height – произвольная информация
table_info string
table-name Возвращает результирующий набор данных с одной строкой для каждой колонки в "table-name". Каждая строка содержит:
(INTEGER) cid – порядковый номер в таблице
(номер первой колонки — 0)
(STRING) name – имя колонки
(STRING) type
(INTEGER) notnull – является ли колонка NOT NULL, 0 — ложь, 1 — истина.
(STRING) dflt_value – значение по умолчанию
(INTEGER) pk – является ли колонка колонкой PRIMARY KEY, 0 — ложь, 1 — истина.
Пример: (метаданные результирующего набора не показаны)
PRAGMA table_info(T);---- - [0, 's1', 'integer', 1, null, 1]- [1, 's2', 'integer', 0, null, 0]...
Синтаксис:
*EXPLAIN explainable-statement;
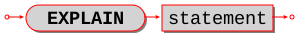
EXPLAIN показывает, какие шаги выполнил бы Tarantool при выполнении explainable-statement. Это средство в первую очередь предназначено для отладки и оптимизации командой Tarantool.
Пример: EXPLAIN DELETE FROM m; возвращает:
- - [0, 'Init', 0, 3, 0, '', '00', 'Start at 3']- [1, 'Clear', 16416, 0, 0, '', '00', '']- [2, 'Halt', 0, 0, 0, '', '00', '']- [3, 'Transaction', 0, 1, 1, '0', '01', 'usesStmtJournal=0']- [4, 'Goto', 0, 1, 0, '', '00', '']
Вариант: EXPLAIN QUERY PLAN statement; показывает шаги поиска.
Синтаксис:
START TRANSACTION;
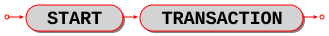
Запуск транзакции. После START TRANSACTION; транзакция считается
«активной». Если транзакция уже активна, выполнение START TRANSACTION;
недопустимо.
Транзакции должны оставаться активными в течение достаточно короткого времени, чтобы избежать проблем с параллельным доступом. Для завершения транзакции используйте COMMIT; или ROLLBACK;.
Как и в NoSQL, на инструкции управления транзакциями распространяются ограничения, накладываемые используемым движком хранения:
- Для движка хранения memtx: если в активной транзакции происходит передача управления (yield), транзакция откатывается.
- Для движка vinyl: передача управления
(yield) разрешена.
Кроме того, хотя инструкции CREATE, DROP и ALTER допустимы внутри транзакций, существует несколько исключений. Например,CREATE INDEX ON {table_name} ...завершится ошибкой внутри многооператорной транзакции, если таблица не пуста.
Однако инструкции управления транзакциями всё еще могут работать не так, как вы ожидаете при запуске через сетевое соединение: транзакция связана с файбером, а не с сетевым соединением, и разные инструкции управления транзакциями, отправленные через одно и то же сетевое соединение, могут быть выполнены разными файберами из пула файберов.
Чтобы гарантировать, что все инструкции являются частью нужной
транзакции, поместите их между START TRANSACTION; и COMMIT; или
ROLLBACK; и отправьте одним пакетом. Например:
- Каждую отдельную SQL-инструкцию оберните в функцию box.execute().
- Передайте все функции
box.execute()на сервер в одном сообщении.
При использовании консоли это можно сделать, записав всё в одну строку.
При использовании net.box это можно сделать, поместив все вызовы функций в одну строку и вызвав eval(string).
Пример:
START TRANSACTION;
Пример полной транзакции, отправленной на сервер localhost:3301 с
помощью eval(string):
net_box = require('net.box')conn = net_box.new('localhost', 3301)s = 'box.execute([[START TRANSACTION;]]) 's = s .. 'box.execute([[INSERT INTO t VALUES (1);]]) 's = s .. 'box.execute([[ROLLBACK;]]) 'conn:eval(s)
Синтаксис:
COMMIT;
Фиксирует активную транзакцию: все изменения сохраняются на постоянной основе, после чего транзакция завершается.
Использование COMMIT недопустимо, если нет активной транзакции. Если транзакция не активна, SQL-операторы фиксируются автоматически.
Пример:
COMMIT;
Синтаксис:
SAVEPOINT {savepoint-name};

Создает точку сохранения, что позволяет выполнить ROLLBACK TO savepoint-name.
SAVEPOINT недопустим, если нет активной транзакции.
Если точка сохранения с таким именем уже существует, она освобождается перед созданием новой точки сохранения.
Пример:
SAVEPOINT x;
Синтаксис:
RELEASE SAVEPOINT {savepoint-name};

Освобождает (удаляет) точку сохранения, созданную с помощью оператора SAVEPOINT.
Использование RELEASE недопустимо при отсутствии активной транзакции.
Точки сохранения освобождаются автоматически при завершении транзакции.
Пример:
RELEASE SAVEPOINT x;
Синтаксис:
ROLLBACK [TO [SAVEPOINT] {savepoint-name}];

Если в ROLLBACK не указан savepoint-name, выполняется откат активной транзакции: все изменения, сделанные после START TRANSACTION, отменяются, и транзакция завершается.
Если в ROLLBACK указан savepoint-name, выполняется откат активной транзакции: все изменения, сделанные после SAVEPOINT savepoint-name, отменяются, но транзакция не завершается.
Использование ROLLBACK недопустимо при отсутствии активной транзакции.
Примеры:
-- the simple form:ROLLBACK;-- the form so changes before a savepoint are not cancelled:ROLLBACK TO SAVEPOINT x;
-- An example of a Lua function that will do a transaction-- containing savepoint and rollback to savepoint.function f()box.execute([[DROP TABLE IF EXISTS t;]]) -- commits automaticallybox.execute([[CREATE TABLE t (s1 STRING PRIMARY KEY);]]) -- commits automaticallybox.execute([[START TRANSACTION;]]) -- after this succeeds, a transaction is activebox.execute([[INSERT INTO t VALUES ('Data change #1');]])box.execute([[SAVEPOINT "1";]])box.execute([[INSERT INTO t VALUES ('Data change #2');]])box.execute([[ROLLBACK TO SAVEPOINT "1";]]) -- rollback Data change #2box.execute([[ROLLBACK TO SAVEPOINT "1";]]) -- this is legal but does nothingbox.execute([[COMMIT;]]) -- make Data change #1 permanent, end the transactionend
Синтаксис:
function-name (one or more expressions)
Применяет встроенную функцию к одному или нескольким выражениям и возвращает скалярное значение.
Tarantool поддерживает 33 встроенные функции.
Максимальное количество операндов для любой функции — 127.
Требуемые привилегии для встроенных функций, вероятно, изменятся в будущей версии.
Ниже приведены встроенные функции Tarantool/SQL. Начиная с Tarantool 2.10 для функций, требующих числовые аргументы, аргументы с типом данных NUMBER недопустимы.
Синтаксис:
ABS({numeric-expression})
Возвращает абсолютное значение числового выражения, которое может быть любого числового типа.
Пример: результат ABS(-1) равен 1.
Синтаксис:
CAST({expression} AS {data-type})
Возвращает значение выражения после приведения к указанному типу данных.
CAST в или из UUID может поменять порядок байтов на little-endian или обратно.
Примеры: CAST('AB' AS VARBINARY), CAST(X'4142' AS STRING)
Синтаксис:
CHAR([numeric-expression [,numeric-expression...])
Возвращает символы, значения кодовых точек Unicode которых равны числовым выражениям.
Короткий пример:
Первые 128 символов Unicode — это символы "ASCII", поэтому результат CHAR(65, 66, 67) равен 'ABC'.
Длинный пример:
Актуальный список символов Unicode, упорядоченный по кодовым точкам, см. на www.unicode.org/Public/UCD/latest/ucd/UnicodeData.txt. В этом списке есть строка для идеограммы линейного письма B
100CC;LINEAR B IDEOGRAM B240 WHEELED CHARIOT ...
Следовательно, чтобы получить строку с колесницей в середине,
используйте оператор конкатенации || и функцию CHAR
'start of string ' || CHAR(0X100CC) || ' end of string'.
Синтаксис:
COALESCE(expression, expression [, expression ...])
Возвращает значение первого выражения, не равного NULL, или NULL, если значения всех выражений равны NULL.
Пример: результат COALESCE(NULL, 17, 32) равен 17.
Синтаксис:
DATE_PART(value_requested , datetime)
Доступно начиная с 2.10.0.
Функция DATE_PART() возвращает запрошенную информацию из значения
DATETIME. Она принимает два аргумента: первый указывает, какая
информация запрашивается, второй — значение DATETIME.
Ниже приведен список поддерживаемых значений первого аргумента и возвращаемой информации:
-
millennium– тысячелетие -
century– век -
decade– десятилетие -
year– год -
quarter– квартал года -
month– месяц года -
week– неделя года -
day– день месяца -
dow– день недели -
doy– день года -
hour– час дня -
minute– минута часа -
second– секунда минуты -
millisecond– миллисекунда секунды -
microsecond– микросекунда секунды -
nanosecond– наносекунда секунды -
epoch– эпоха -
timezone_offset– смещение часового пояса от UTC в минутах.
Примеры:
tarantool> select date_part('millennium', cast({'year': 2000, 'month': 4, 'day': 5, 'hour': 6, 'min': 33, 'sec': 22, 'nsec': 523999111} as datetime));---- metadata:- name: COLUMN_1type: integerrows:- [2]...tarantool> select date_part('day', cast({'year': 2000, 'month': 4, 'day': 5, 'hour': 6, 'min': 33, 'sec': 22, 'nsec': 523999111} as datetime));---- metadata:- name: COLUMN_1type: integerrows:- [5]...tarantool> select date_part('nanosecond', cast({'year': 2000, 'month': 4, 'day': 5, 'hour': 6, 'min': 33, 'sec': 22, 'nsec': 523999111} as datetime));---- metadata:- name: COLUMN_1type: integerrows:- [523999111]...
Синтаксис:
GREATEST({expression-1}, {expression-2}, [{expression-3} ...])
Возвращает наибольшее значение из переданных выражений. Если любое из
выражений равно NULL, возвращает NULL. Обратная функция для GREATEST
— LEAST.
Примеры: GREATEST(7, 44, -1) возвращает 44;
GREATEST(1E308, 'a', 0, X'00') возвращает '0' — нулевой символ;
GREATEST(3, NULL, 2) возвращает NULL
Синтаксис:
HEX(expression)
Возвращает шестнадцатеричный код для каждого байта выражения expression.
Начиная с версии Tarantool 2.10.0 выражение должно быть последовательностью байтов (тип данных VARBINARY).
В предыдущих версиях Tarantool выражение могло быть либо строкой, либо последовательностью байтов. Для символов ASCII оно выполнялось довольно прямолинейно, поскольку значение каждого символа в кодировке ASCII совпадает с его значением в шестнадцатеричной схеме. В случае с символами, не входящими в таблицу ASCII, для каждого символа потребуется два байта или более, поскольку строки символов обычно кодируются в UTF-8.
Примеры:
-
HEX(X'41')вернёт41. -
HEX(CAST('Д' AS VARBINARY))вернётD094.
Синтаксис:
IFNULL(expression, expression)
Возвращает значение первого выражения, не равного NULL. Если значения
обоих выражений равны NULL, возвращает NULL. Таким образом,
IFNULL(expression, expression) — это то же самое, что и
COALESCE(expression, expression).
Пример: IFNULL(NULL, 17) возвращает 17
Синтаксис:
LEAST({expression-1}, {expression-2}, [{expression-3} ...])
Возвращает наименьшее значение из переданных выражений. Если любое из
выражений равно NULL, возвращает NULL. Обратная функция для LEAST —
GREATEST.
Примеры: LEAST(7, 44, -1) возвращает -1; LEAST(1E308, 'a', 0, X'00')
возвращает 0; LEAST(3, NULL, 2) возвращает NULL.
Синтаксис:
LENGTH(expression)
Возвращает количество символов в expression или количество байтов в
expression. Это зависит от типа данных: строки с типом данных STRING
подсчитываются в символах, байтовые последовательности с типом данных
VARBINARY подсчитываются в байтах и не завершаются нулевым символом. У
LENGTH(expression) есть два псевдонима — CHAR_LENGTH(expression) и
CHARACTER_LENGTH(expression), которые выполняют то же самое.
Примеры:
-
LENGTH('ДД')возвращает 2 — строка содержит 2 символа. -
LENGTH(CAST('ДД' AS VARBINARY))возвращает 4 — строка содержит 4 байта. -
LENGTH(CHAR(0, 65))возвращает 2 — '0' не означает «конец строки». -
LENGTH(X'410041')возвращает 3 — байтовые последовательности X'...' имеют тип VARBINARY.
Синтаксис:
LIKELIHOOD({expression}, {DOUBLE literal})
Возвращает выражение без изменений, при условии, что числовое значение находится в диапазоне от 0.0 до 1.0.
Пример: LIKELIHOOD('a' = 'b', .0) возвращает FALSE
Синтаксис:
LIKELY({expression})
Возвращает TRUE, если выражение, вероятно, истинно.
Пример: LIKELY('a' = 'b') возвращает TRUE
Синтаксис:
LOWER({string-expression})
Возвращает выражение, в котором символы верхнего регистра преобразованы
в нижний регистр. Обратная функция для LOWER —
UPPER.
Пример: LOWER('ДA') возвращает 'дa'
Синтаксис:
NOW()
Доступно начиная с 2.10.0.
Функция NOW() возвращает текущие дату и время в виде значения типа DATETIME.
Если функция вызывается в запросе более одного раза, она возвращает одинаковый результат до завершения запроса, если не происходит yield. При yield значение, возвращаемое NOW(), изменяется.
Примеры:
tarantool> select now(), now(), now()---- metadata:- name: COLUMN_1type: datetime- name: COLUMN_2type: datetime- name: COLUMN_3type: datetimerows:- ['2022-07-20T19:02:02.010812282+0300', '2022-07-20T19:02:02.010812282+0300', '2022-07-20T19:02:02.010812282+0300']...
Синтаксис:
NULLIF(expression-1, expression-2)
Возвращает expression-1, если expression-1 <> expression-2, в противном случае возвращает NULL.
Примеры:
NULLIF('a', 'A')возвращает 'a'.NULLIF(1.00, 1)возвращает NULL.
Синтаксис:
POSITION({expression-1}, {expression-2})
Возвращает позицию expression-1 внутри expression-2 или 0, если expression-1 не встречается внутри expression-2. Типы данных выражений должны быть STRING или VARBINARY. Если выражения имеют тип данных STRING, результатом является позиция символа. Если выражения имеют тип данных VARBINARY, результатом является позиция байта.
Короткий пример: POSITION('C', 'ABC') возвращает 3
Развернутый пример: UTF-8 кодировка латинской буквы A в
шестнадцатеричном виде — 41; UTF-8 кодировка кириллической буквы Д —
D094. Это можно проверить, выполнив SELECT HEX('ДA'); и увидев, что
результат — 'D09441'. Если теперь выполнить
SELECT POSITION('A', 'ДA'); результатом будет 2, так как 'A' —
второй символ в строке. Однако, если выполнить
SELECT POSITION(X'41', X'D09441'); результатом будет 3, так как
X'41' — третий байт в последовательности байтов.
Синтаксис:
PRINTF(string-expression [, expression ...])
Возвращает строку, отформатированную по правилам функции C sprintf(),
где %d%s означает, что следующие два аргумента — числовой и
строка, и так далее.
Если аргумент отсутствует или равен NULL, он принимает следующее значение:
- '0', если формат требует целое число,
- '0.0', если формат требует число с десятичной точкой,
- '', если формат требует строку. Пример:
PRINTF('%da', 5)возвращает '5a'.
Синтаксис:
QUOTE(string)
Возвращает строку с добавлением внешних кавычек при необходимости, а также с экранированием внутренних кавычек, если это требуется. Эта функция полезна для создания строк, являющихся частью SQL-запросов, поскольку согласно правилам SQL строковые литералы заключаются в одинарные кавычки, а одинарные кавычки внутри таких строк представляются двумя идущими подряд одинарными кавычками.
Начиная с версии Tarantool 2.10 аргументы с числовыми типами данных возвращаются без изменений.
Примеры: QUOTE('a') вернет 'a', QUOTE(5) вернет 5.
Синтаксис:
RAISE(FAIL, {error-message})
Может использоваться только внутри триггерного оператора. См. также Активация триггеров.
Синтаксис: RANDOM()
Возвращает 19-значное целое число, сгенерированное генератором псевдослучайных чисел.
Пример: RANDOM() возвращает 6832175749978026034 или любое другое целое
число.
Синтаксис:
RANDOMBLOB({n})
Возвращает последовательность байтов длиной n байт с типом данных VARBINARY, содержащую байты, сгенерированные генератором псевдослучайных байтов. Результат может быть преобразован в шестнадцатеричный формат. Если n меньше 1, равен NULL или бесконечности, возвращается NULL.
Пример: HEX(RANDOMBLOB(3)) возвращает '9EAAA8' или шестнадцатеричное
значение любой другой трехбайтовой строки.
Синтаксис:
REPLACE({expression-1}, {expression-2}, {expression-3})
Возвращает expression-1, но при этом каждое вхождение expression-2 внутри expression-1 заменяется на expression-3. Все выражения должны иметь тип данных STRING или VARBINARY.
Пример: REPLACE('AAABCCCBD', 'B', '!') возвращает 'AAA!CCC!D'
Синтаксис:
ROUND({numeric-expression-1} [, {numeric-expression-2}])
Возвращает округленное значение первого числового выражения. Положительные числа округляются до 0,5 в большую сторону, отрицательные — до 0,5 в меньшую. Если задано второе числовое выражение, то первое округляется до ближайших цифр после десятичной точки второго выражения. Если второе выражение не задано, первое округляется до ближайшего целого числа.
Пример: ROUND(-1.5) возвращает -2, ROUND(1.7766E1,2) возвращает
17.77.
ROW_COUNT()
Возвращает количество строк, которые были вставлены / обновлены / удалены последним оператором INSERT, UPDATE, DELETE или REPLACE. Строки, обновленные оператором UPDATE, учитываются, даже если их значения не изменились. Строки, которые были вставлены / обновлены / удалены в результате действия внешнего ключа, не учитываются. Строки, которые были вставлены / обновлены / удалены с помощью триггеров INSTEAD OF для представлений, не учитываются. После оператора CREATE или DROP ROW_COUNT() возвращает 1. После выполнения других операторов ROW_COUNT() возвращает 0.
Пример: ROW_COUNT() возвращает 1 после успешной вставки одной строки с
помощью INSERT.
Особое правило при наличии триггеров BEFORE или AFTER: фактически счетчик ROW_COUNT() сохраняется в начале серии триггерных операторов и восстанавливается в конце. Поэтому после выполнения следующих операторов:
CREATE TABLE t1 (s1 INTEGER PRIMARY KEY);CREATE TABLE t2 (s1 INTEGER, s2 STRING, s3 INTEGER, PRIMARY KEY (s1, s2, s3));CREATE TRIGGER tt1 BEFORE DELETE ON t1 FOR EACH ROW BEGININSERT INTO t2 VALUES (old.s1, '#2 Triggered', ROW_COUNT());INSERT INTO t2 VALUES (old.s1, '#3 Triggered', ROW_COUNT());END;INSERT INTO t1 VALUES (1),(2),(3);DELETE FROM t1;INSERT INTO t2 VALUES (4, '#4 Untriggered', ROW_COUNT());SELECT * FROM t2;
Результат:
---- - [1, '#2 Сработал', 3]- [1, '#3 Сработал', 1]- [2, '#2 Сработал', 3]- [2, '#3 Сработал', 1]- [3, '#2 Сработал', 3]- [3, '#3 Сработал', 1]- [4, '#4 Не сработал', 3]...
Синтаксис:
SOUNDEX(string-expression)
Возвращает строку из четырех символов, представляющую звучание
string-expression. Часто слова и имена с разным написанием имеют
одинаковое представление Soundex, если они произносятся похоже, поэтому
возможен поиск по звучанию. Алгоритм работает с символами латинского
алфавита и лучше всего подходит для английских слов.
Пример: SOUNDEX('Crater') и SOUNDEX('Creature') оба возвращают
C636.
Синтаксис:
SUBSTR({string-or-varbinary-value}, {numeric-start-position} [, {numeric-length}])
Если string-or-varbinary-value имеет тип данных STRING, возвращается подстрока, начинающаяся с позиции символа numeric-start-position и продолжающаяся на numeric-length символов (если numeric-length указан), или до конца string-or-varbinary-value (если numeric-length не указан).
Если numeric-start-position меньше 1 или если numeric-start-position + numeric-length больше длины string-or-varbinary-value, результатом не будет ошибка — все, что находится до начала или после конца, игнорируется. Не существует символов с индексом <= 0 или с индексом больше длины первого аргумента.
Если numeric-length меньше 0, возникает ошибка.
Если string-or-varbinary-value имеет тип данных VARBINARY, а не STRING, позиционирование и подсчет осуществляются по байтам, а не по символам.
Примеры: SUBSTR('ABCDEF', 3, 2) возвращает 'CD',
SUBSTR('абвгде', -1, 4) возвращает 'аб'
Синтаксис:
TRIM([[LEADING|TRAILING|BOTH] [{expression-1}] FROM] {expression-2})
Возвращает expression-2 после удаления всех начальных и/или конечных символов или байтов. Выражения должны иметь тип данных STRING или VARBINARY. Если LEADINGTRAILINGBOTH опущено, по умолчанию используется BOTH. Если expression-1 опущено, по умолчанию используется ' ' (пробел) для типа данных STRING или X'00' (ноль) для типа данных VARBINARY.
Примеры:
TRIM('a' FROM 'abaaaaa') возвращает 'b' — все повторения 'a'
удалены с обеих сторон; TRIM(TRAILING 'ב' FROM 'אב') возвращает 'א'
— если все символы иврита, TRAILING означает «слева»;
TRIM(X'004400') возвращает X'44' — последовательность байтов по
умолчанию для обрезки — X'00', если тип данных VARBINARY;
TRIM(LEADING 'abc' FROM 'abcd') возвращает 'd' — expression-1
может содержать более одного символа.
Синтаксис:
TYPEOF({expression})
Возвращает 'NULL', если выражение равно NULL. Возвращает 'scalar',
если выражение — это имя колонки, определенной как SCALAR. В
остальных случаях возвращает тип данных
выражения.
Примеры:
TYPEOF('A') вернет 'string'; TYPEOF(RANDOMBLOB(1)) вернет
'varbinary'; TYPEOF(1e44) вернет 'double' или 'number';
TYPEOF(-44) вернет 'integer'; TYPEOF(NULL) вернет 'NULL'.
До версии Tarantool 2.10 TYPEOF(выражение) возвращало тип данных
результата выражения во всех случаях.
Синтаксис:
UNICODE(string-expression)
Возвращает значение кодовой точки Unicode первого символа string-expression. Если string-expression пуст, возвращается NULL. Это обратная функция к CHAR(integer).
Пример: UNICODE('Щ') возвращает 1065 (шестнадцатеричное 0429).
Синтаксис:
UNLIKELY({expression})
Возвращает TRUE, если выражение, вероятно, ложно. Ограничение: на
практике UNLIKELY может возвращать то же, что и
LIKELY.
Пример: UNLIKELY('a' <= 'b') возвращает TRUE.
Синтаксис:
UPPER(string-expression)
Возвращает выражение, в котором строчные символы преобразованы в
прописные. Обратная функция к UPPER — LOWER.
Пример: UPPER('-4щl') возвращает '-4ЩL'.
Синтаксис:
UUID([integer])
Возвращает универсальный уникальный идентификатор, тип данных UUID. Опционально можно указать номер версии, однако на данный момент единственной возможной версией является 4, которая установлена по умолчанию. Поддержка UUID в SQL была добавлена в версии Tarantool 2.9.1.
Пример: UUID() или UUID(4)
Синтаксис:
VERSION()
Возвращает версию Tarantool.
Пример: для сборки от февраля 2020 года VERSION() возвращает
'2.4.0-35-g57f6fc932'.
Синтаксис:
ZEROBLOB({n})
Возвращает последовательность байтов длиной n байт, тип данных = VARBINARY.
COLLATE collation-name
collation-name должен указывать на существующее правило сортировки.
Предложение COLLATE допускается для элементов типа STRING или SCALAR:
() в CREATE INDEX
() в
CREATE TABLE как часть
определения колонки
() в CREATE TABLE как часть
определения UNIQUE
() в строковых
выражениях
Примеры:
-- In CREATE INDEXCREATE INDEX idx_unicode_mb_1 ON mb (s1 COLLATE "unicode");-- In CREATE TABLECREATE TABLE t1 (s1 INTEGER PRIMARY KEY, s2 STRING COLLATE "unicode_ci");-- In CREATE TABLE ... UNIQUECREATE TABLE mb (a STRING, b STRING, PRIMARY KEY(a), UNIQUE(b COLLATE "unicode_ci" DESC));-- In string expressionsSELECT 'a' = 'b' COLLATE "unicode"FROM tWHERE s1 = 'b' COLLATE "unicode"ORDER BY s1 COLLATE "unicode";
Список правил сортировки можно просмотреть с помощью: PRAGMA collation_list;
Правила сортировки полностью соответствуют Техническому стандарту
Unicode #10 ("Unicode Collation
Algorithm"), а порядок символов по
умолчанию соответствует Default Unicode Collation Element Table
(DUCET).
Существует множество постоянных правил сортировки; наиболее часто
используемые:
NBSP NBSP "none" (неприменимо)
NBSP NBSP
"unicode" (символы в порядке DUCET со strength = 'tertiary')
NBSP
NBSP "unicode_ci" (символы в порядке DUCET со strength = 'primary')
NBSP NBSP "binary" (символы в порядке кодовых точек)
Эти
идентификаторы должны быть заключены в кавычки и указаны в нижнем
регистре, так как они используются в нижнем регистре в
правилах сортировки Tarantool/NoSQL.
При указании COLLATE "binary" это эквивалентно запросу того, что
иногда называется «порядком кодовых точек», поскольку, если содержимое
представлено в кодировке UTF-8, символы с большими кодовыми точками
будут располагаться после символов с меньшими кодовыми точками.
В выражении COLLATE является оператором с более высоким приоритетом,
чем у всех остальных, кроме ~. Это допустимо, поскольку других
полезных операторов, кроме || и операторов сравнения, нет. После ||
правило сортировки сохраняется.
В выражении с более чем одним предложением COLLATE, если имена правил
сортировки различаются, возникает ошибка: "Illegal mix of collations".
В выражении без предложений COLLATE литералы имеют правило сортировки
"binary", а колонки — правило сортировки, заданное в CREATE TABLE.
Иными словами, для выбора правила сортировки Tarantool использует:
первое предложение COLLATE в выражении, если оно указано,
иначе
предложение COLLATE колонки, если оно указано,
иначе "binary".
Однако для поиска, а иногда и для сортировки, может использоваться
правило сортировки индекса, поэтому все предложения COLLATE, не
относящиеся к индексу, игнорируются.
EXPLAIN не покажет имя использованного правила сортировки, но отобразит его характеристики.
Пример со шведским правилом сортировки:
Зная, что "sv" —
двухбуквенный код шведского языка,
и зная, что "s1" означает
strength = 1,
и увидев с помощью PRAGMA collation_list;, что
существует правило сортировки с именем unicode_sv_s1,
проверим, равны
ли две строки согласно шведским правилам (да, равны):
SELECT 'ÄÄ' = 'ĘĘ' COLLATE "unicode_sv_s1";
Пример с русским, украинским и киргизским правилами сортировки:
Зная,
что русское правило сортировки практически совпадает с правилом Unicode
по умолчанию,
и зная, что двухбуквенные коды украинского и
киргизского — 'uk' и 'ky',
и зная, что в русском (но не в
украинском) 'Г' = 'Ґ' при strength=primary,
и зная, что в русском
(но не в киргизском) 'Е' = 'Ё' при strength=primary,
три
приведенных здесь оператора SELECT вернут результаты в трех разных
порядках:
CREATE TABLE things (remark STRING PRIMARY KEY);
INSERT INTO things VALUES ('Е2'), ('Ё1');
INSERT INTO things VALUES ('Г2'), ('Ґ1');
SELECT remark FROM things ORDER BY remark COLLATE "unicode";
SELECT remark FROM things ORDER BY remark COLLATE "unicode_uk_s1";
SELECT remark FROM things ORDER BY remark COLLATE "unicode_ky_s1";
Начиная с Tarantool 2.10, если параметр для
агрегатной функции или
встроенной скалярной SQL-функции является одним из
extra-parameters, которые могут передаваться в запросах
box.execute(...[,extra-parameters]), тип
данных по умолчанию вычисляется следующим образом:
- Если возможен
только один тип данных, он используется по умолчанию.
Пример:box.execute([[SELECT TYPEOF(LOWER(?));]],{x})— 'string'.
Если возможные типы данных — INTEGER, DOUBLE или DECIMAL, по умолчанию
используется DECIMAL.
Пример:
box.execute([[SELECT TYPEOF(AVG(?));]],{x}) — 'decimal'.
*
Если возможные типы данных — STRING или VARBINARY, по умолчанию
используется STRING.
Пример:
box.execute([[SELECT TYPEOF(LENGTH(?));]],{x}) — 'string'.
*
Если возможные типы данных — любые другие скалярные типы данных, по
умолчанию используется SCALAR.
Пример:
box.execute([[SELECT TYPEOF(GREATEST(?,5));]],{x}) — 'scalar'.
- Если возможный тип данных — нескалярный тип данных, например ARRAY, результат не определен.
- В остальных случаях тип по умолчанию
отсутствует.
Пример:box.execute([[SELECT TYPEOF(LIKELY(?));]],{x})— имя одного из примитивных типов данных.