
Архитектура
Рассмотрим распределенный Tarantool-кластер, состоящий из подкластеров под названием шарды, в каждом из которых хранится некоторая часть данных. Каждый шард, в свою очередь, представляет собой набор реплик, одна из которых служит ведущим узлом, обрабатывающим все запросы на чтение и запись.
Весь набор данных при шардировании распределяется на заданное количество виртуальных сегментов (далее по тексту просто сегменты). Каждому из них присваивается уникальный номер от 1 до N, где N – это общее количество сегментов. Специально выбирается количество сегментов на несколько порядков больше, чем потенциальное количество кластерных узлов даже с учетом будущего масштабирования кластера. Например, если предполагается M узлов, набор данных может быть разделен на 100 * M или даже 1000 * M сегментов. Особое внимание следует уделить выбору количества сегментов: слишком большое число может потребовать дополнительную память для хранения информации о маршрутизации; слишком маленькое может привести к снижению степени детализации балансировки.
Каждый шард хранит уникальное подмножество сегментов. Один сегмент не может относиться к нескольким шардам одновременно, как показано на схеме ниже:
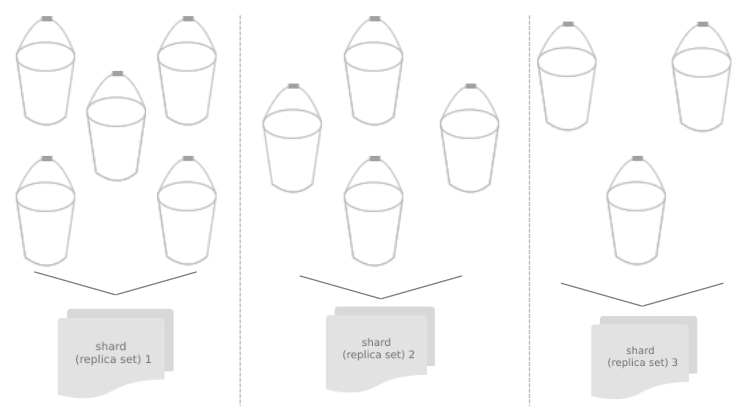
Такая схема распределения сегментов по шардам хранится в таблице в одном из системных спейсов Tarantool, при этом в каждом шарде содержится только определенная часть схемы, которая покрывает присвоенные этому шарду сегменты.
Помимо таблицы, идентификатор сегмента также хранится в специальном поле каждого кортежа каждой таблицы, участвующей в шардировании.
Как только шард получает любой запрос (за исключением SELECT) от приложения, этот шард сверяет идентификатор сегмента, указанный в запросе, с таблицей идентификаторов сегментов, которые принадлежат данному узлу. Если указанный идентификатор сегмента недействителен, то запрос завершается со следующей ошибкой: "wrong bucket" (неверный сегмент). В противном случае запрос выполняется, и всем создаваемым данным присваивается указанный в запросе идентификатор сегмента. Обратите внимание, что запрос должен изменять только данные с тем же идентификатором сегмента, что и в запросе.
Хранение идентификаторов сегментов как в самих данных, так и в таблице обеспечивает согласованность данных независимо от логики приложения и прозрачность балансировки для приложения. Хранение таблицы соответствий в системном спейсе обеспечивает последовательность шардирования в случае восстановления после отказа, так как у всех реплик в шарде будет одно исходное состояние таблицы.
Набор данных при шардировании распределяется на большое количество абстрактных узлов, которые называются виртуальные сегменты (далее по тексту просто сегменты).
Секционирование набора данных происходит с помощью сегментного ключа (или идентификатора сегмента (bucket id) в терминах Tarantool). Идентификатор сегмента – это число от 1 до N, где N – это общее количество сегментов.
В каждом наборе реплик есть уникальное подмножество сегментов. Один сегмент не может относиться к нескольким наборам реплик одновременно.
Общее количество сегментов определяется администратором при настройке начальной конфигурации кластера.
Каждый спейс, который планируется использовать для шардирования, должен иметь числовое поле, содержащее идентификаторы сегментов. Подробнее см. в разделе Определение данных.
Сегментированный кластер в Tarantool состоит из:
-
Один или несколько наборов реплик.
Каждый набор реплик должен содержать как минимум два экземпляра хранилища. Для обеспечения резервирования рекомендуется иметь 3 и более экземпляров хранилища в наборе реплик.
-
Один или несколько экземпляров роутера.
Количество экземпляров роутера не ограничено и должно быть увеличено, если существующие экземпляры роутера становятся ограниченными по CPU или вводу-выводу.
-
Балансировщик.
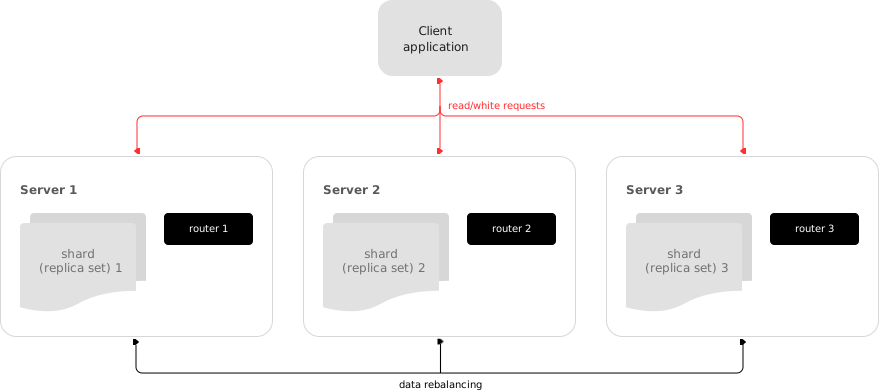
Хранилище (storage) – это узел, который хранит подмножество набора данных. Несколько реплицируемых (для резерва) хранилищ составляют набор реплик (также называемый шардом).
У каждого хранилища в наборе реплик есть роль: мастер или реплика. Мастер обрабатывает запросы на чтение и запись. Реплика обрабатывает запросы на чтение, но не может обрабатывать запросы на запись.
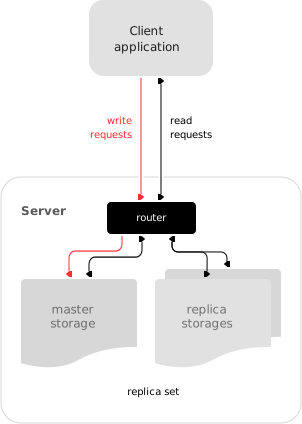
Роутер (router) – это автономный компонент ПО, который обеспечивает маршрутизацию запросов чтения и записи от клиентского приложения к шардам.
Все запросы из приложения приходят в сегментированный кластер через роутер (router). Роутер сохраняет топологию
сегментированного кластера прозрачной для приложения, не сообщая приложению:
- Количество и расположение шардов,
- Процесс балансировки данных,
- Факт и процесс отработки отказа, произошедшего после сбоя реплики.
Роутер также может самостоятельно вычислить идентификатор сегмента при условии, что приложение четко определяет правила вычисления идентификатора сегмента на основе данных запроса. Для этого роутеру необходимо знать схему данных.
У роутера нет постоянного статуса, он не хранит топологию кластера и не выполняет балансировку данных. Роутер – это автономный компонент ПО, который может работать на уровне хранилища или на уровне приложения в зависимости от функций приложения.
Роутер поддерживает постоянный пул соединений со всеми хранилищами, созданными при запуске, что помогает избежать ошибок
конфигурации. После создания пула роутер кэширует текущее состояние таблицы _vbucket, чтобы ускорить маршрутизацию. Если
сегмент был перемещен в другое хранилище в результате балансировки, или же один из шардов переключается на реплику, роутер
обновит таблицу маршрутизации так, чтобы это было понятно приложению.
Шардирование не интегрировано ни в одну систему централизованного хранения конфигураций. Предполагается, что само приложение обрабатывает взаимодействие с такой системой и передает параметры шардирования. При этом конфигурацию можно изменить динамически, например, при добавлении или удалении одного или нескольких шардов:
- Чтобы добавить новый шард в кластер, системный администратор сначала изменяет конфигурацию всех роутеров, а затем конфигурацию всех хранилищ.
- Новый шард становится доступен уровню хранилища для балансировки.
- В результате балансировки один из виртуальных сегментов перемещается на новый шард.
- При попытке обращения к виртуальному сегменту роутер получает специальный код ошибки, указывающий новое расположение виртуального сегмента.
CRUD-операции могут:
- Выполняться в хранимой процедуре внутри хранилища.
- Инициироваться приложением.
В любом случае приложение должно включать идентификатор рабочего сегмента в запрос. При выполнении запроса вставки INSERT идентификатор сегмента хранится в созданном кортеже. В других случаях проверяется, совпадает ли указанный идентификатор рабочего сегмента с идентификатором сегмента кортежа, в который вносятся изменения.
Поскольку хранилище не знает о соответствии идентификатора сегмента и первичного ключа, все запросы выборки SELECT в хранимых процедурах внутри хранилища выполняются только локально. SELECT-запросы, которые были инициализированы приложением, направляются на роутер. И если приложение передало идентификатор сегмента, роутер использует его для вычисления шарда.
Существует несколько способов вызвать хранимые процедуры в наборах реплик кластера. Хранимые процедуры можно вызвать:
- На конкретном виртуальном сегменте, расположенном в наборе реплик (в этом случае необходимо различать процедуры чтения и записи, так как процедуры записи неприменимы к виртуальным сегментам, находящимся в процессе миграции).
- Без указания конкретного виртуального сегмента.
Все проверки правильности маршрутизации, выполняемые для шардированных DML-операций, распространяются и на хранимые процедуры, связанные с сегментами.
Балансировщик представляет собой фоновый процесс балансировки, который обеспечивает равномерное распределение сегментов по шардам. Во время балансировки происходит миграция сегментов по наборам реплик.
Балансировщик периодически «просыпается» и перераспределяет данные с наиболее загруженных узлов на менее загруженные. Балансировка запускается, если дисбаланс набора реплик превышает пороговое значение дисбаланса, заданное в конфигурации.
Дисбаланс набора реплик вычисляется следующим образом:
|эталонное_число_сегментов - текущее_число_сегментов| / эталонное_число_сегментов * 100
Набор реплик, из которого переносится сегмент, называется исходный (source); а набор реплик, куда переносится сегмент, называется целевой (destination).
Блокировка набора реплик позволяет набору реплик оставаться невидимым для балансировщика. Набор реплик с блокировкой не может ни принимать новые сегменты, ни мигрировать свои собственные.
Во время миграции у сегмента могут быть разные статусы:
- ACTIVE – сегмент доступен для запросов на чтение и запись.
- PINNED – сегмент заблокирован для миграции на другой набор реплик. В остальном заблокированные сегменты аналогичны сегментам в состоянии ACTIVE.
- SENDING – сегмент в настоящее время копируется на целевой набор реплик; запросы на чтение к исходному набору реплик по-прежнему обрабатываются.
- RECEIVING – сегмент в настоящее время заполняется; все запросы к нему отклоняются.
- SENT – сегмент перенесен на целевой набор реплик.
routerиспользует состояние SENT для вычисления нового расположения сегмента. Сегмент в состоянии SENT автоматически переходит в состояние GARBAGE через 0,5 секунды. - GARBAGE – сегмент уже был перенесен на целевой набор реплик в процессе балансировки; или сегмент изначально находился в состоянии RECEIVING, но во время миграции произошла ошибка.
Сегменты в статусе GARBAGE удаляются сборщиком мусора.
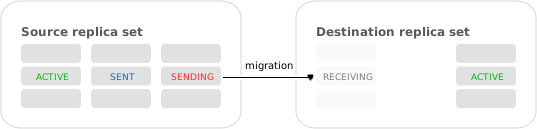
Миграция происходит следующим образом:
- На целевом наборе реплик создается новый сегмент, которому присваивается состояние RECEIVING, начинается копирование данных, а сегмент отклоняет все запросы.
- Исходному сегменту в исходном наборе реплик присваивается состояние SENDING, и сегмент продолжает обрабатывать запросы на чтение.
- После копирования данных сегменту на исходном наборе реплик присваивается состояние SENT, и он начинает отклонять все запросы.
- Сегменту на целевом наборе реплик присваивается состояние ACTIVE, и он начинает принимать все запросы.
Системный спейс _bucket в каждом наборе реплик хранит идентификаторы сегментов данного набора реплик. Спейс содержит следующие
поля:
bucket– идентификатор сегмента.status– состояние сегмента.destination– UUID целевого набора реплик.
Пример _bucket.select{}:
---- - [1, ACTIVE, abfe2ef6-9d11-4756-b668-7f5bc5108e2a]- [2, SENT, 19f83dcb-9a01-45bc-a0cf-b0c5060ff82c]...
После миграции сегмента UUID целевого набора реплик вносится в таблицу. Пока сегмент еще находится в исходном наборе реплик,
значение UUID целевого набора реплик равно NULL.
Таблица маршрутизации роутера отображает все идентификаторы сегментов с соответствующими наборами реплик. Она обеспечивает консистентность шардирования в случае отказа.
Роутер поддерживает постоянный пул соединений со всеми хранилищами, созданными при запуске, что помогает избежать ошибки
конфигурации. После создания пула соединений роутер кэширует текущее состояние таблицы маршрутизации, чтобы ускорить ее. Если
произошла миграция сегмента в другое хранилище после балансировки или же отказ, который вызвал переключение шарда на другую
реплику, файбер обнаружения (discovery fiber) в роутере обновит таблицу маршрутизации автоматически.
Поскольку идентификатор сегмента явно указан как в данных, так и в таблице отображения на роутере, данные сохраняются независимо от логики приложения. Это также обеспечивает прозрачность балансировки для приложения.
Запросы в базу данных можно производить из приложения или с помощью хранимых процедур. В любом случае идентификатор сегмента следует явным образом указать в запросе.
Сначала все запросы направляются в роутер. Роутер поддерживает только операцию вызова, которая выполняется с помощью функции
vshard.router.call():
result = vshard.router.call(<идентификатор_сегмента>, <режим>, <имя_функции>, {<список_аргументов>}, {<опции>})
Запросы обрабатываются следующим образом:
-
routerиспользует идентификатор сегмента для поиска набора реплик с соответствующим сегментом в таблице маршрутизации.Если соответствие идентификатора сегмента и набора реплик неизвестно
router(файбер обнаружения еще не заполнил таблицу),routerотправляет запросы всемstorages, чтобы определить расположение сегмента. -
После того как сегмент найден, шард проверяет:
- Хранится ли сегмент в системном спейсе
_bucketнабора реплик. - Находится ли сегмент в состоянии ACTIVE или PINNED (для запроса на чтение также допускается состояние SENDING).
- Хранится ли сегмент в системном спейсе
-
Если все проверки пройдены успешно, запрос выполняется. В противном случае он завершается с ошибкой:
"wrong bucket".
Вертикальное масштабирование
Увеличение мощности одного сервера: использование более мощного CPU, добавление оперативной памяти, увеличение дискового пространства и т. д.
Горизонтальное масштабирование
Добавление новых серверов в пул ресурсов с последующим секционированием и распределением набора данных (dataset) по серверам.
Шардирование
Архитектура базы данных, позволяющая секционировать набор данных с помощью ключа шардирования и распределять набор данных по нескольким серверам. Шардирование является частным случаем горизонтального масштабирования.
Узел (node)
Виртуальный или физический экземпляр сервера.
Кластер
Набор узлов, которые составляют отдельную группу.
Хранилище (storage)
Узел, который хранит подмножество данных из набора данных.
Набор реплик (replica set)
Набор узлов хранилища, хранящих копии набора данных. Каждое хранилище в наборе реплик имеет роль: мастер или реплика.
Мастер
Хранилище в наборе реплик, которое обрабатывает запросы на чтение и запись.
Реплика
Хранилище в наборе реплик, которое обрабатывает только запросы на чтение.
Запросы на чтение
Запросы только на чтение, то есть выборка.
Запросы на запись
Операции по изменению данных, то есть запросы на создание, чтение, изменение и удаление данных.
Сегменты, виртуальные сегменты (buckets, virtual buckets)
Абстрактные виртуальные узлы, на которые секционируется набор данных с помощью ключа шардирования (идентификатора сегмента, он же bucket id).
Идентификатор сегмента (bucket id)
Ключ шардирования, определяющий, какому набору реплик принадлежит сегмент. Идентификатор сегмента может быть вычислен на основе хеш-ключа.
Роутер (router)
Прокси-сервер, отвечающий за маршрутизацию запросов от приложения к узлам в кластере.